AXXA Agent


English · Português (Brasil)
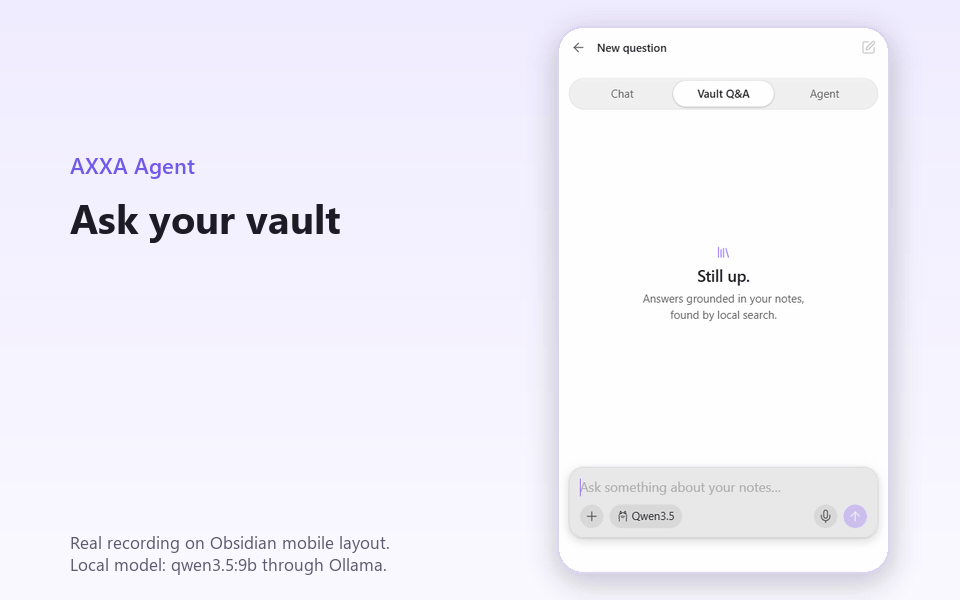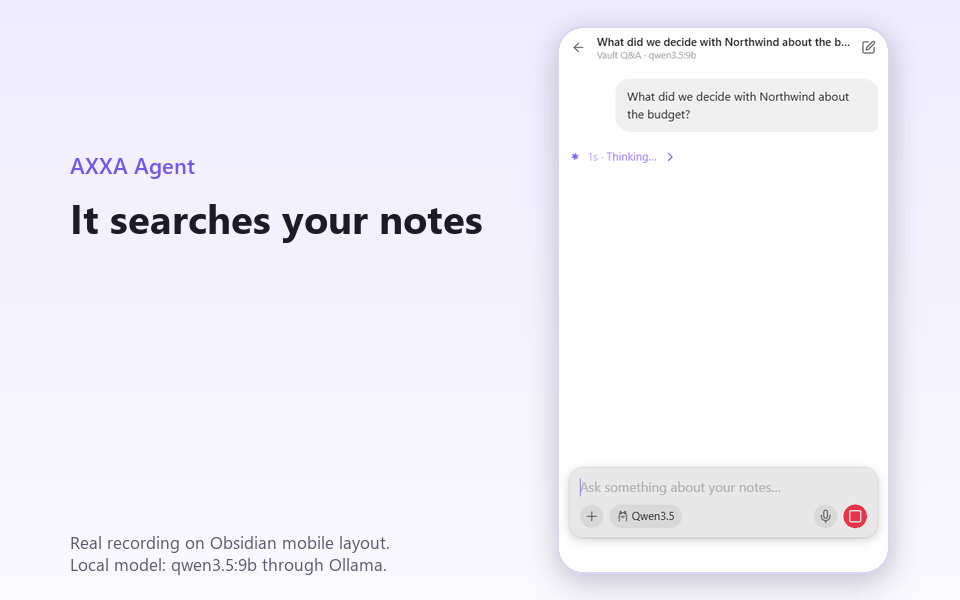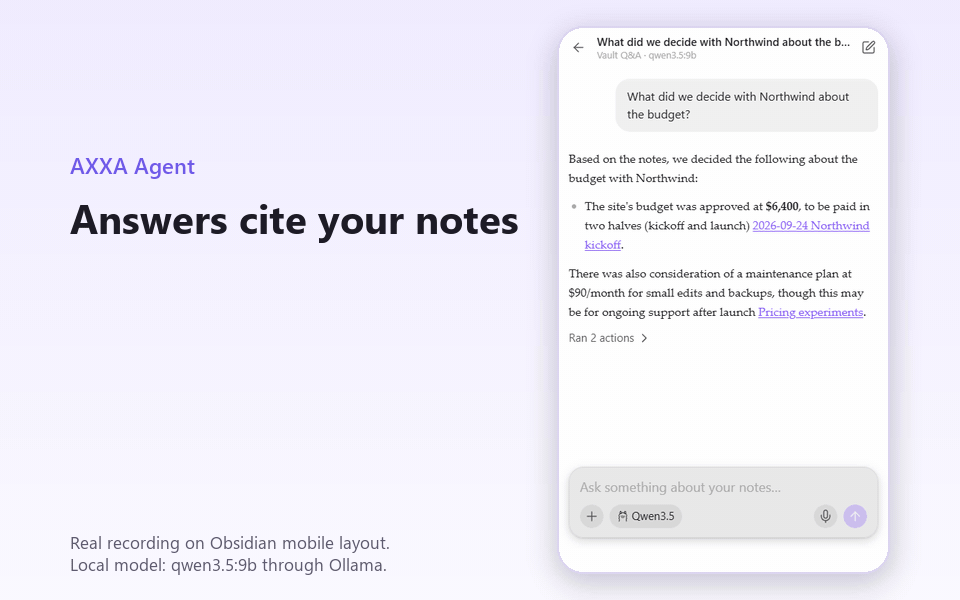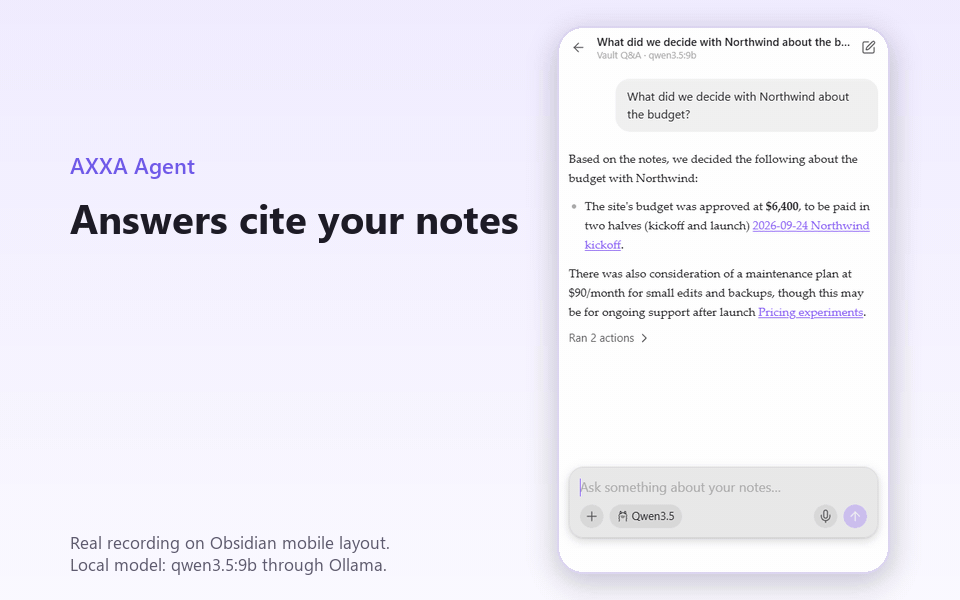
Converse, pergunte ao seu vault e deixe um agente editar suas notas, no celular e no desktop.
Seis provedores, suas próprias chaves de API, cada conversa salva em Markdown.
Site · Instalar · Começo rápido · Privacidade · Perguntas · Discussions
> A interface do plugin está em inglês e em português do Brasil. Por padrão ela segue o idioma do Obsidian, e dá pra trocar em Settings › AXXA Agent › Chat › Language (com o Obsidian em português, Configurações › AXXA Agent › Chat › Idioma).
## O que ele faz
- **Três modos, um painel.** Chat, Vault Q&A sobre as suas notas e um Agente que trabalha nos seus arquivos.
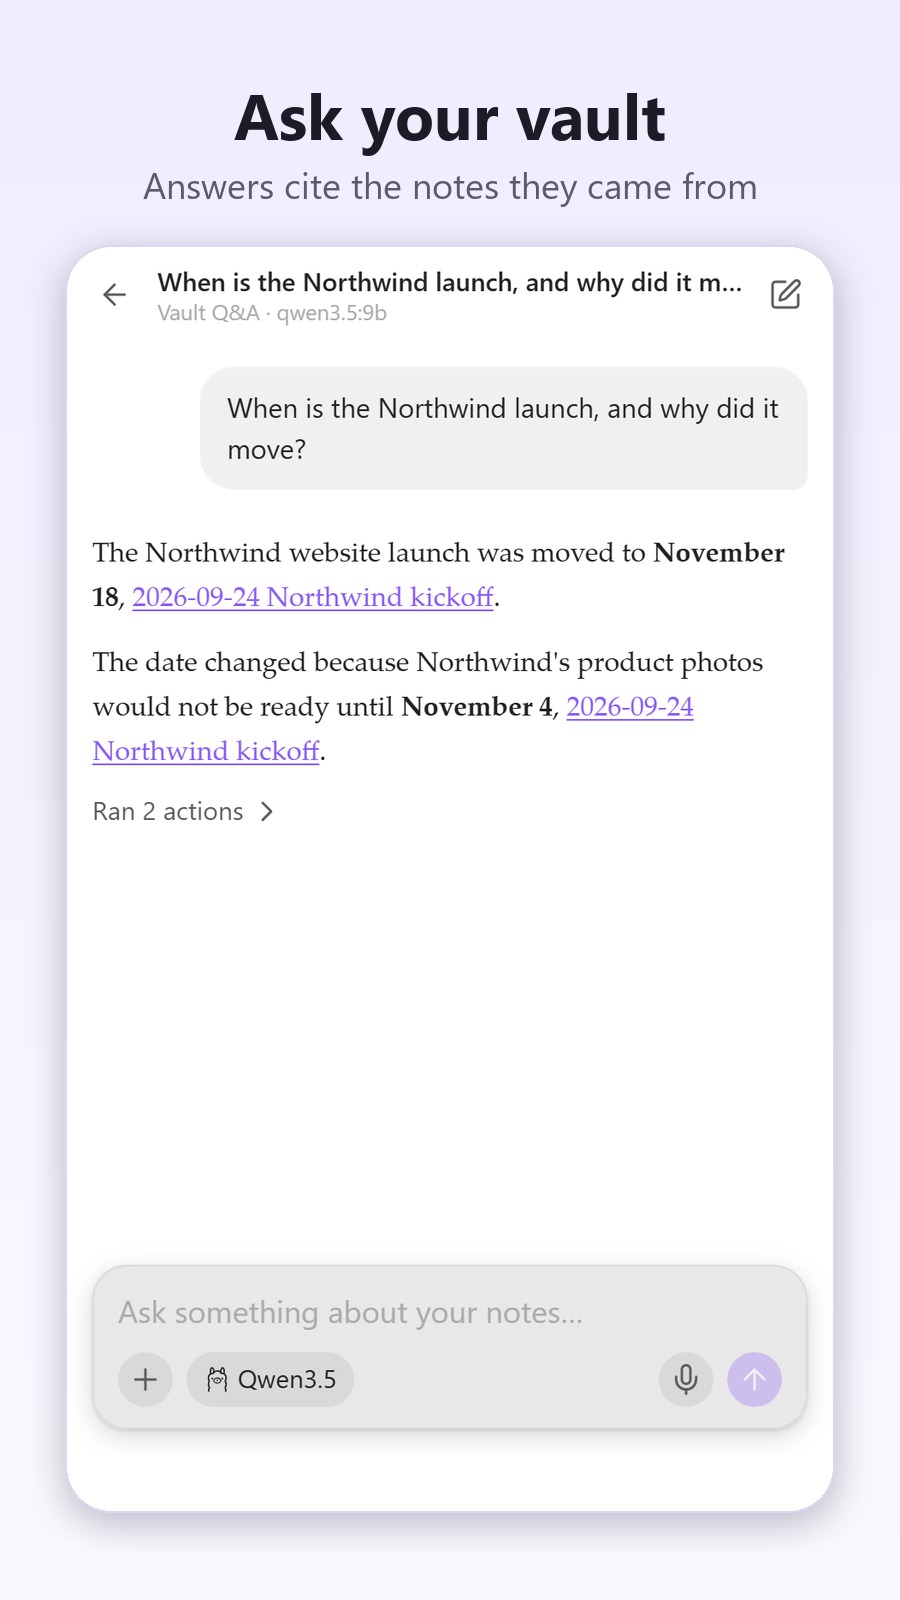
- **Respostas que citam as suas notas.** O Vault Q&A faz busca híbrida (palavra-chave + vetor, reordenada pelos seus links) e cita as notas que usou como wikilinks que abrem a nota.
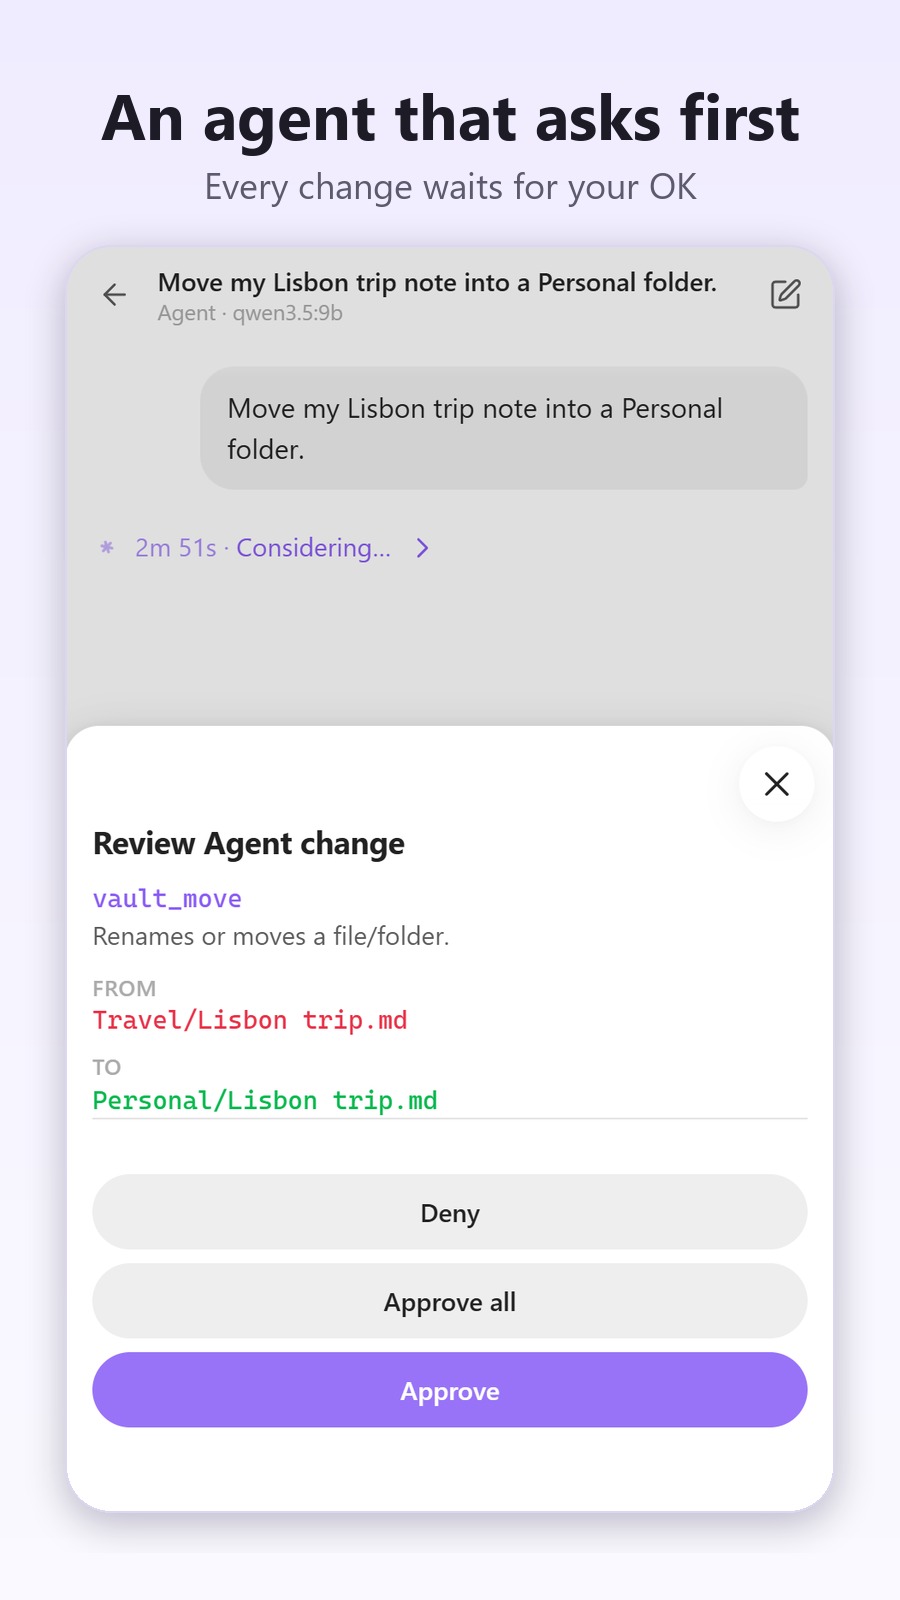
- **Um agente que pergunta antes.** Ele cria, edita, move e apaga notas por um conjunto pequeno de ferramentas. Por padrão, toda mudança espera o seu OK; mover reescreve os seus `[[links]]`, e apagar segue a configuração de lixeira do Obsidian.
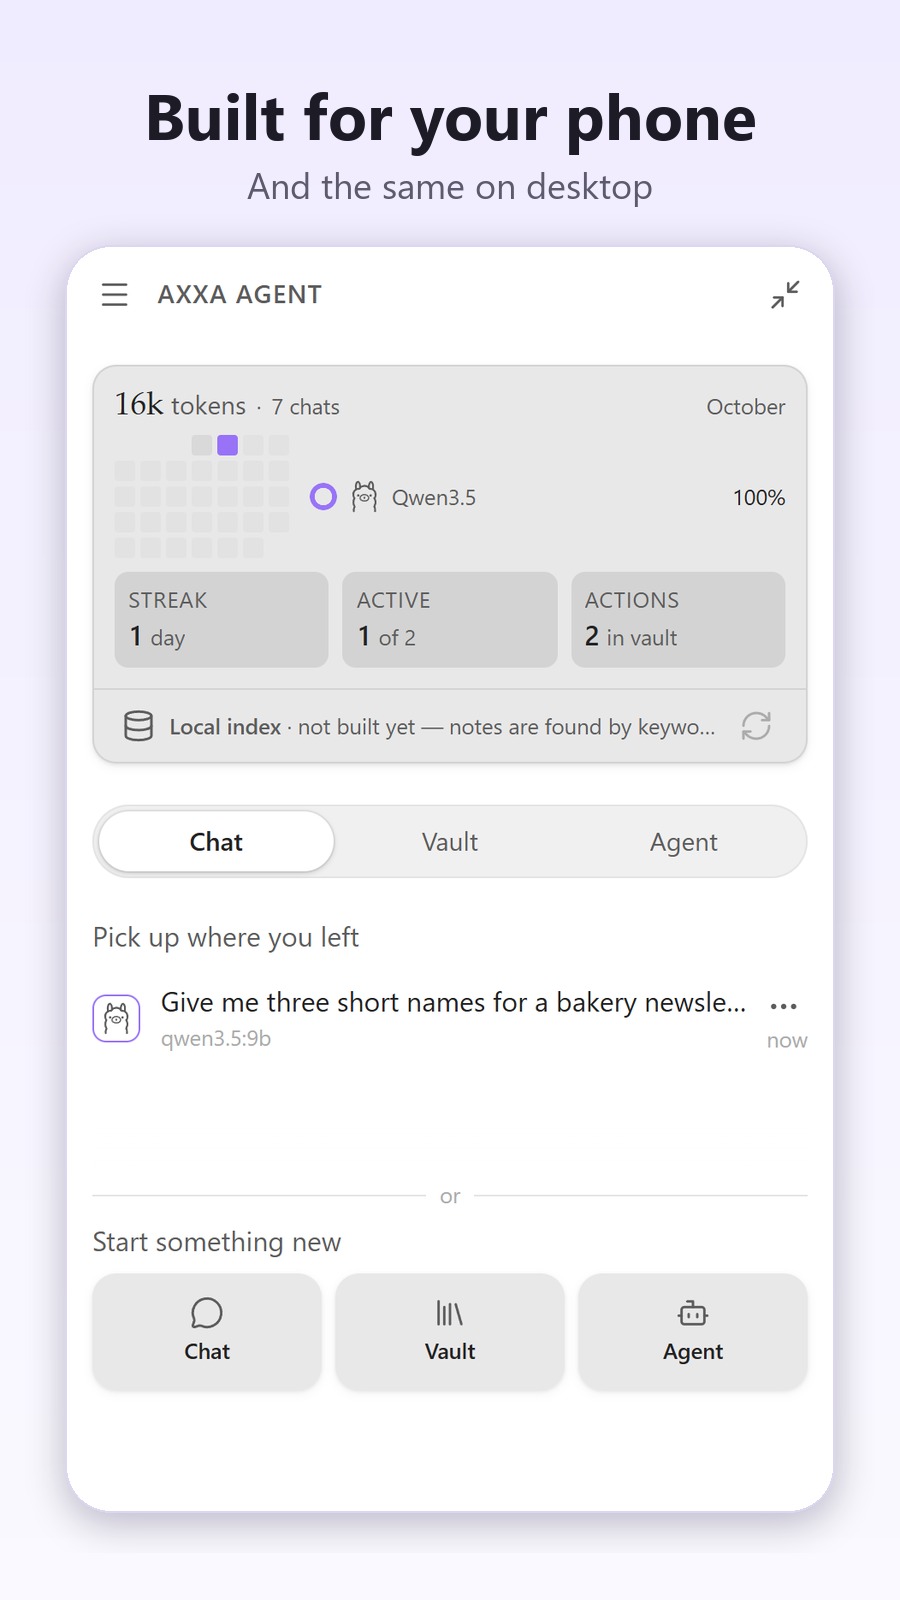
- **Feito pro celular.** Desenhado primeiro pra gaveta do Obsidian no celular: o composer acompanha o teclado, há um modo tela cheia opcional, e o agente funciona no celular também.
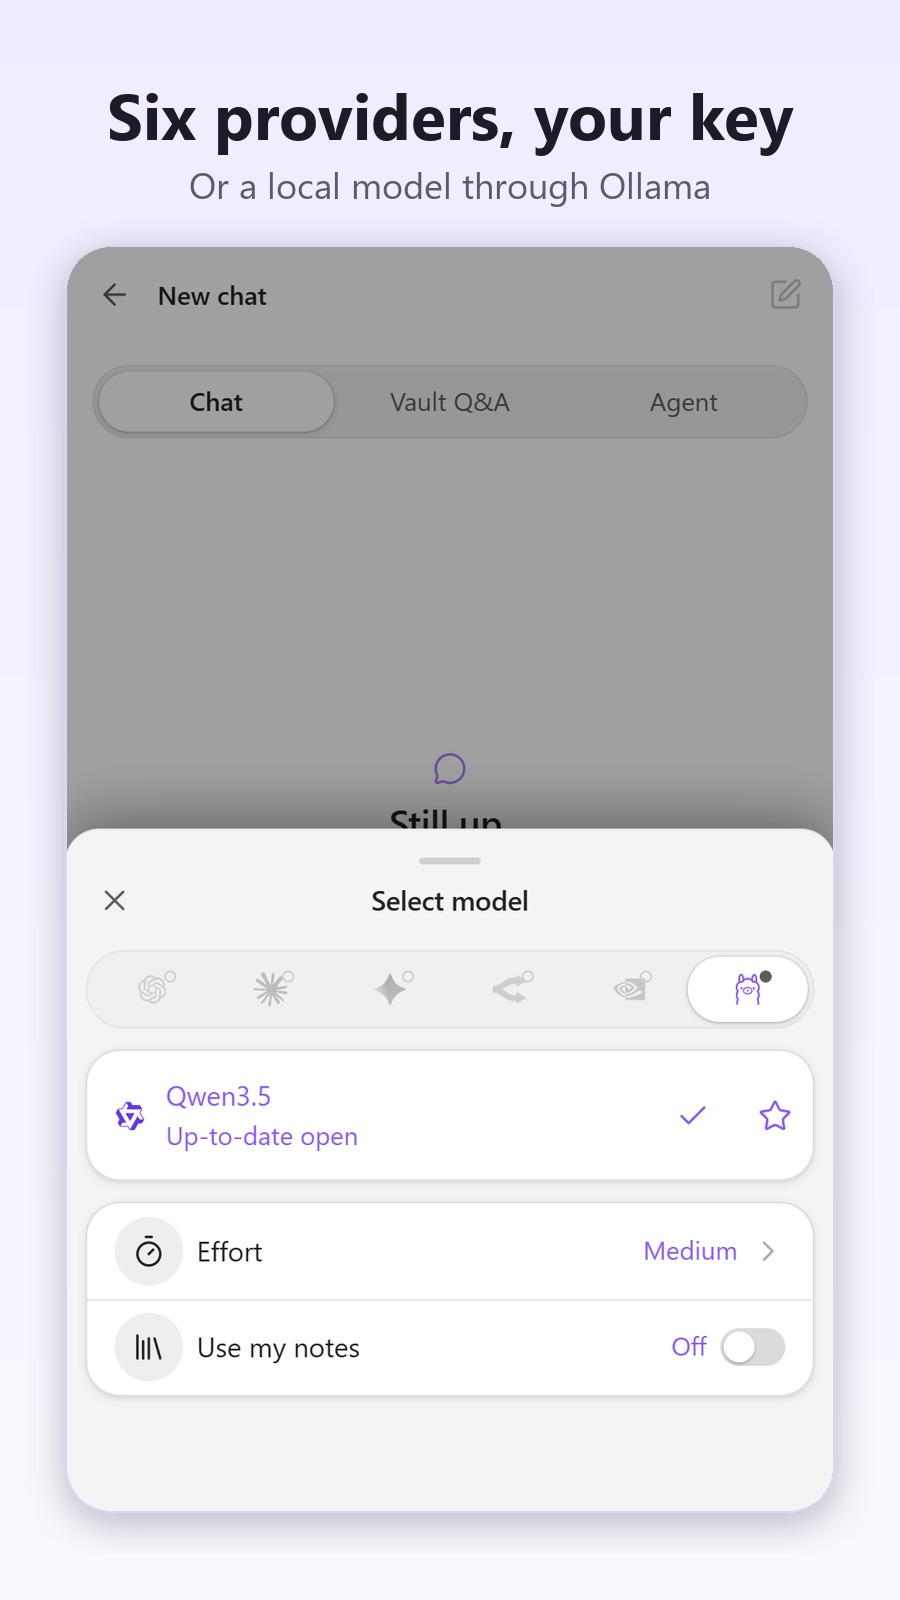
- **Seis provedores, suas chaves.** OpenAI, Anthropic, Google Gemini, OpenRouter, NVIDIA NIM e Ollama local. As chaves ficam no cofre do sistema.
- **Pequeno e rápido.** O `main.js` tem menos de 0,6 MB (587.963 bytes na 0.9.24). Os 12 plugins de IA mais baixados têm mediana de uns 3,8 MB (medido em outubro de 2026).
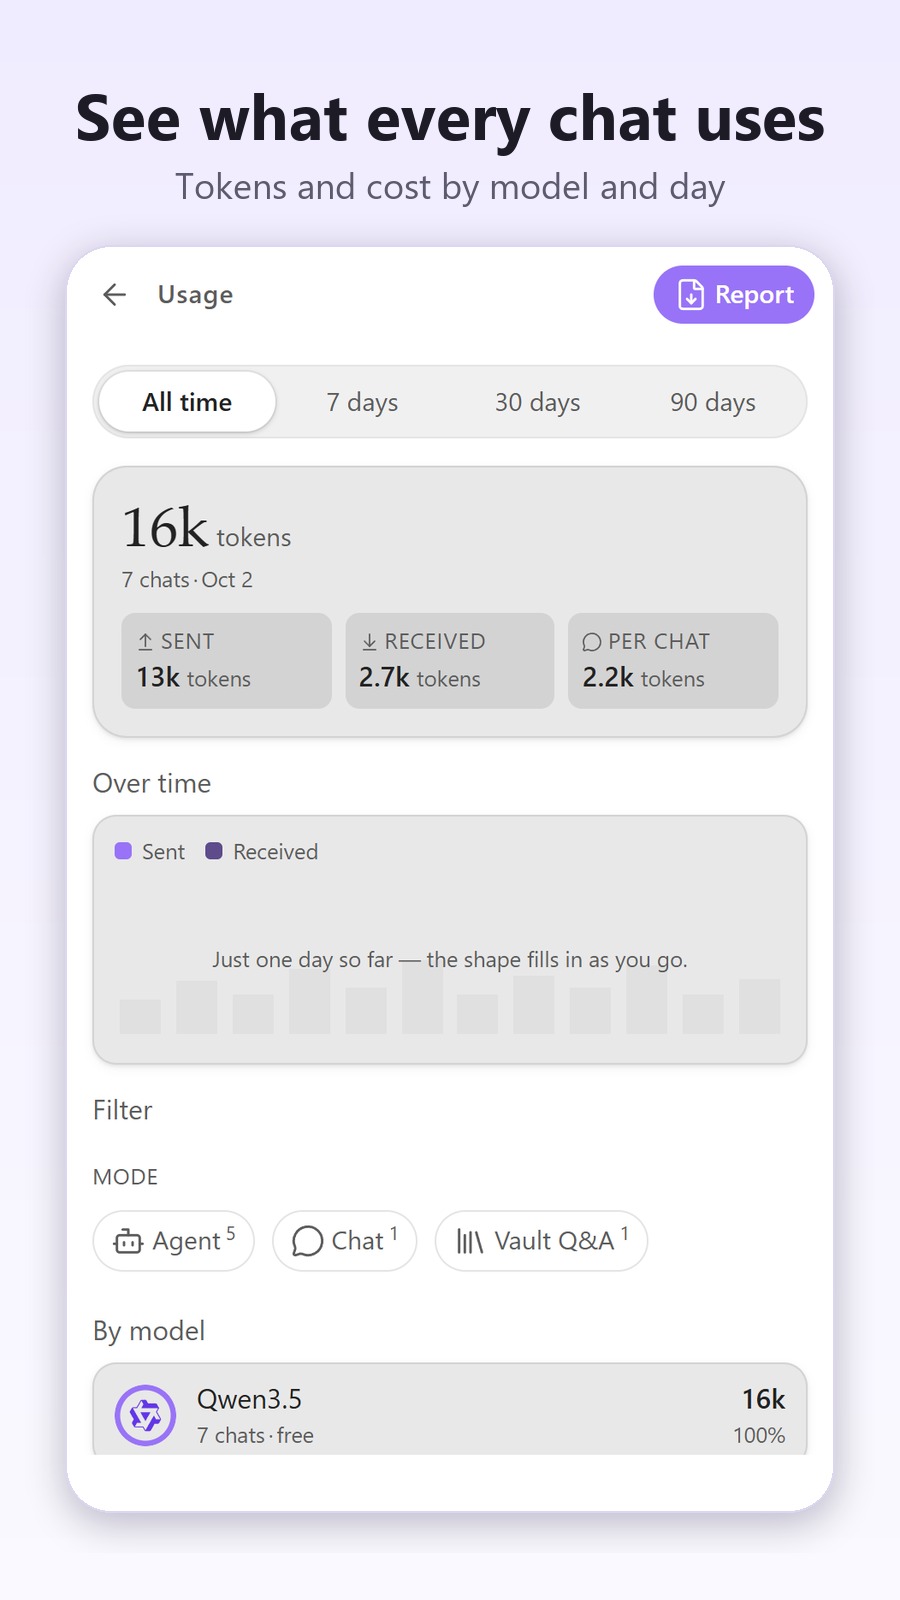
- **Tudo é Markdown.** Conversas, skills e relatórios de custo são arquivos no seu vault, e um painel de uso mostra o gasto por provedor, modelo e dia, e o que sobra hoje em cada cota grátis.
Mais telas
## Instalação
Precisa do Obsidian **1.11.4** ou mais novo, no desktop ou no celular, e de uma chave de API de um provedor ou de um servidor Ollama local.
1. Abra a [página do AXXA Agent no diretório](https://community.obsidian.md/plugins/axxa-agent) e toque em **Add to Obsidian**, ou no Obsidian vá em **Settings → Community plugins → Browse** e busque **AXXA Agent**.
2. Toque em **Install** e depois em **Enable**.
3. Abra pelo ícone da barra lateral ou pela paleta de comandos (**AXXA Agent: Open**).
### Versões de teste (BRAT)
As versões de teste saem como pré-releases no GitHub. Instale o [BRAT](https://github.com/TfTHacker/obsidian42-brat), adicione `axxalab/axxa-agent`, e o BRAT mantém você na beta mais recente. Beta pode quebrar; o diretório sempre entrega a versão estável.
Instalação manual
1. Baixe `main.js`, `manifest.json` e `styles.css` da [última release](https://github.com/axxalab/axxa-agent/releases/latest).
2. Copie para `/.obsidian/plugins/axxa-agent/`.
3. Recarregue o Obsidian e ative o plugin em **Settings → Community plugins**.
## Começo rápido
1. Abra **Settings → AXXA Agent → Providers**.
2. Coloque a chave de um provedor ([onde conseguir](#provedores)) ou o endereço do seu servidor Ollama (normalmente `http://localhost:11434`).
3. Comece uma conversa na tela inicial, escolha o modo e envie.
**Jeitos grátis de começar:** a cota grátis do Google Gemini (num projeto sem cobrança ativada), os modelos grátis do OpenRouter, os Free Endpoints do NVIDIA NIM, ou um modelo local pelo Ollama, que não pede chave nem conta. A primeira mensagem trava o provedor, o modelo e o modo daquela conversa.
## Os três modos
| Modo | O que faz |
|---|---|
| **Chat** | Uma conversa com o modelo que você escolher: respostas em streaming, Markdown, botão de copiar nas respostas, nos blocos de código e nas suas mensagens. Sem acesso ao vault, a não ser que você ligue. |
| **Vault Q&A** | Respostas ancoradas nas suas notas. A busca acha os trechos relevantes e a resposta cita de onde vieram. |
| **Agente** | O modelo usa ferramentas no seu vault: buscar, listar, ler, criar, editar, mover e apagar notas e pastas, com confirmação. |
Como o Vault Q&A busca
- Busca híbrida: semelhança semântica mais busca por palavra-chave (achar no título da nota vale mais que achar no texto), reordenada pelo grafo de links do vault.
- Modelos de embedding de 5 provedores: OpenAI (`text-embedding-3-small/large`, `ada-002`), Gemini (`gemini-embedding-001`, `text-embedding-004`), NVIDIA NIM (os modelos de embedding que o catálogo dele lista quando você busca os modelos), o Nemotron VL grátis do OpenRouter, que também faz embedding de imagens, e o seu Ollama (por exemplo o `nomic-embed-text`), que deixa a indexação e a busca na sua máquina.
- O índice fica salvo no vault e se atualiza só nos arquivos que mudaram. Sem modelo de embedding (ou offline com um da nuvem), a busca usa só palavra-chave.
## Provedores
Todos usam a sua própria chave. Você só precisa de uma.
| Provedor | Tipo | Opção grátis | Onde conseguir a chave |
|---|---|---|---|
| **OpenAI** | Nuvem | Tokens grátis por dia pra organizações elegíveis que compartilham dados da API | [platform.openai.com/api-keys](https://platform.openai.com/api-keys) |
| **Anthropic (Claude)** | Nuvem | Não | [console.anthropic.com](https://console.anthropic.com/) |
| **Google Gemini** | Nuvem | Cota grátis em projeto sem cobrança; geração de imagem é paga | [aistudio.google.com/apikey](https://aistudio.google.com/apikey) |
| **OpenRouter** | Nuvem, muitos modelos | Modelos grátis: 50 pedidos por dia, 1.000 depois de US$ 10 em créditos | [openrouter.ai/keys](https://openrouter.ai/keys) |
| **NVIDIA NIM** | Nuvem | Free Endpoints: 20 modelos hospedados, 40 pedidos por minuto, pra desenvolvimento | [build.nvidia.com](https://build.nvidia.com/) |
| **Ollama** | Local, sem chave | Grátis | [ollama.com](https://ollama.com/), depois coloque o endereço do servidor em Settings |
A lista de modelos vem ao vivo de cada provedor. Etiquetas mostram o que cada modelo faz (visão, ferramentas, geração de imagem ou áudio), e um aviso aparece quando o modelo não faz o que o modo precisa. Um modelo grátis traz o limite dele: `free · 50/day` no OpenRouter (o número da sua chave), `free · 40/min` no NVIDIA NIM, `free tier` no Gemini, e a cota diária na OpenAI (`250k/day` nos tiers 1–2) com o compartilhamento de dados ligado, com um `+` na frente enquanto está desligado.
## Segurança do agente
O agente usa oito ferramentas no seu vault: `vault_search`, `vault_list`, `vault_read`, `vault_create`, `vault_edit`, `vault_move`, `vault_delete` e `vault_create_folder`. Com o **Web access** ligado (Settings › Agent), ele ganha duas na web: `web_search`, que precisa da sua chave da [Tavily](https://tavily.com) (1.000 buscas grátis por mês), e `web_fetch`, que abre uma página pública. Nos níveis Ask e Vault, cada pedido à web mostra antes o endereço ou a busca (a menos que você tenha dado **Approve all** num pedido à web anterior da mesma rodada), e endereço local (o seu computador, a sua rede de casa) é sempre recusado. Três níveis de permissão decidem o que ele faz sem perguntar:
- **Ask** (padrão): toda mudança espera o seu OK.
- **Vault**: criar, editar e mover rodam sozinhos; apagar ainda pergunta.
- **YOLO**: tudo roda sozinho, inclusive apagar. O que se apaga vai para a lixeira; se o Obsidian estiver configurado para apagar de vez, apagar continua perguntando.
Toda mudança do agente pode ser desfeita pela conversa: o **Undo** embaixo da resposta desfaz a rodada inteira, e cada ação da lista tem o seu. O desfazer preserva o que você mudou à mão depois, a menos que você escolha sobrescrever, e vale enquanto o Obsidian estiver aberto.
Os caminhos ficam presos ao seu vault, e a confirmação mostra exatamente o que vai mudar.
## Privacidade e dados
- **Sem telemetria, sem conta, nada enviado pra nós.** As requisições vão só pros provedores que você configurar e pras páginas que você pedir pra ler.
- **As chaves ficam no aparelho**, no cofre do sistema (o `secretStorage` do Obsidian), nunca no `data.json`, então não viajam pelo Sync nem por backup.
- **As suas notas só saem do aparelho pro provedor que você escolheu**, numa conversa ou no índice do Vault Q&A. O índice em si fica no vault.
- **Offline com o Ollama.** O chat, o Vault Q&A e o agente podem rodar todos na sua máquina com o Ollama (o Vault Q&A precisa de um modelo de embedding, como o `nomic-embed-text`; o agente, de um modelo com ferramentas).
Ao usar um provedor terceiro, valem os termos e a política de privacidade dele.
### Declarações
Pelas políticas de desenvolvedor do Obsidian, em linguagem direta:
- **Uso de rede.** As requisições vão só pros provedores de IA que você configurar (OpenAI, Anthropic, Google Gemini, OpenRouter, NVIDIA NIM, ElevenLabs pras vozes opcionais da leitura e o seu Ollama), pras páginas da web que você pedir pra buscar no **+ › Link** e, com o **Web access** do agente ligado, pra busca e as páginas descritas abaixo. O que cada um recebe:
- o provedor do chat: as suas mensagens, as notas, arquivos, imagens, PDFs e páginas que você anexa, e os trechos do vault descritos em *Contexto automático*. As notas e páginas anexadas e o texto colado vão de novo a cada mensagem seguinte da conversa (até essa parte de uma conversa longa virar resumo), e as imagens e PDFs também, nas 3 mensagens mais recentes que trazem esses arquivos, enquanto a conversa estiver aberta. A OpenAI e o OpenRouter também recebem um ID aleatório por conversa, usado pro cache do prompt. Quando uma conversa longa chega perto do limite do modelo, o mesmo provedor recebe também um pedido pra resumir o começo dela, com o texto das mensagens antigas, os nomes das notas e arquivos que foram junto e as ações do agente, com um trecho curto do resultado de cada uma;
- o provedor de embedding (Vault Q&A): o texto das suas notas enquanto o índice é montado, e as imagens também se você escolher um modelo de embedding que aceita imagem, mais cada busca;
- a API de transcrição da OpenAI: as suas gravações de voz, quando você dita;
- a OpenAI ou a ElevenLabs: o texto de uma resposta, quando você toca em Listen;
- o endereço da chave do OpenRouter (`openrouter.ai/api/v1/key`), com a sua chave do OpenRouter, quando você busca os modelos do OpenRouter ou abre o Usage: ele só lê a cota de pedidos grátis da chave, o crédito que sobra e o gasto de hoje;
- o catálogo público de modelos da NVIDIA (`api.ngc.nvidia.com`), quando você busca a lista de modelos do NIM: uma busca pelos modelos que a NVIDIA marca *Free Endpoint*, pra lista saber quais são grátis de verdade. Sem chave, e nada seu vai junto;
- a API de busca da Tavily (`api.tavily.com`), com a sua chave da Tavily, quando o agente busca na web: a busca que o agente escreveu;
- uma página que o agente abre (`web_fetch`): um pedido simples daquele endereço, que você vê e aprova antes, a menos que o nível de permissão seja YOLO ou que você tenha dado **Approve all** num pedido à web anterior da mesma rodada.
Não há telemetria e nada é enviado pra nós. As respostas são renderizadas como Markdown, então um link de imagem dentro de uma resposta é carregado de onde ele aponta.
- **Contas e pagamento.** O plugin é gratuito, mas precisa da sua chave de pelo menos um provedor (o Ollama, rodando local, não precisa). A maioria cobra o uso da API por token; alguns oferecem modelos ou cotas gratuitas.
- **Listagem do vault.** O plugin lê a lista de arquivos do vault (o `getMarkdownFiles` / `getFiles` do Obsidian) pra montar o índice do Vault Q&A, pra metade por palavra-chave da busca no vault (Vault Q&A, contexto do Agent e a ferramenta `vault_search` do agente), pro seletor de notas (**+ › Notes**, menções `[[` e fontes de projeto) e, só se você ligar *Let it see your note names* (que vem desligado), pra assistente de criação sugerir notas pra um projeto. A lista fica no aparelho, com três exceções: nesse último caso os caminhos de até 300 notas recentes (nunca o conteúdo) vão pro modelo da assistente; no modo Agent a ferramenta `vault_list` manda os nomes dos arquivos de uma pasta (a raiz inclusive) pro modelo do chat, sem perguntar; e a `vault_search` manda os caminhos e trechos das notas que acha.
- **Contexto automático.** Nas conversas de Vault Q&A e Agent, um interruptor de vault por conversa nasce **ligado**: trechos das notas que combinam com a sua mensagem vão junto dela pro provedor do chat e ficam guardados nela, então vão de novo a cada mensagem seguinte da conversa (até essa parte de uma conversa longa virar resumo). No Chat ele nasce **desligado**.
- **Arquivos lidos e gravados.** As conversas e o índice do Vault Q&A ficam dentro do vault, na pasta oculta `.axxa/` por padrão. Cada arquivo de conversa guarda também, em base64 (que não é criptografia), num comentário oculto em cada mensagem sua, os trechos do vault e o texto das notas, textos colados e páginas que foram junto com ela, além do resumo do começo de uma conversa longa. Quando você pede, exportações vão pra `axxa-ai/exports/`, relatórios de uso pra `axxa-ai/reports/` e skills pra `axxa-ai/skills/`. No modo Agent o modelo pode ler qualquer arquivo de texto do vault e criar, editar, mover e apagar notas e pastas pelas ferramentas dele. Mudanças pedem confirmação conforme o nível de permissão escolhido (e o **Approve all** dessa confirmação deixa de perguntar pelas mudanças reversíveis até o fim daquela rodada; dado num pedido à web, vale só pros pedidos à web da rodada); apagar pergunta em todos os níveis menos no YOLO, e mesmo nele quando o Obsidian está configurado pra apagar de vez. Toda mudança do agente pode ser desfeita pela conversa enquanto o Obsidian estiver aberto.
Por que o plugin usa fetch, e a única API do Node que ele toca
O Obsidian recomenda o `requestUrl` dele pras requisições de rede, e o AXXA usa ele em tudo que dá. Mas o `requestUrl` devolve a resposta inteira de uma vez e não faz streaming, e é o streaming que faz a resposta aparecer enquanto é escrita (e que faz o **Stop** parar o modelo de verdade). Por isso as respostas do chat da OpenAI, Anthropic, Gemini, OpenRouter e Ollama chegam pelo `fetch` do navegador, num único ponto (`fetchStream` em `src/providers/_shared.ts`). Esse ponto chama `window.fetch`, exatamente a mesma função que `fetch` (o nome solto é só um atalho pra ela). O linter da revisão do Obsidian só confere o nome solto, então deixou de acusar essa chamada; preferimos dizer isso aqui a deixar a revisão parecer "sem `fetch`". Se o streaming não conseguir conectar (por exemplo, barrado por CORS no celular), o plugin cai no `requestUrl` e mostra a resposta inteira de uma vez.
O provedor NVIDIA NIM pede ao Electron o `https` do Node pra fazer streaming no desktop ([`nim.ts`](src/providers/nim.ts)). Isso fica atrás do `Platform.isMobile`, dentro de try/catch, com checagem de formato, e cai no `requestUrl`; no celular esse caminho nunca roda.
## Perguntas frequentes
É grátis?
Sim. Tudo o que o plugin faz hoje é grátis, sem plano, sem conta e sem chave de licença, e continua assim. Se um dia existirem opções pagas, serão coisas novas por cima, nunca um cadeado em algo que já funcionava. Você paga o provedor de IA direto; o plugin não fica com nada.
O agente funciona no celular?
Sim. Chat, Vault Q&A e o agente com as confirmações rodam no app do Obsidian no celular. Provedores na nuvem funcionam em qualquer lugar; o Ollama roda num computador, então usar ele do celular precisa de um servidor Ollama que o celular alcance.
O que sai do meu aparelho?
Só o que vai pro provedor que você escolheu: suas mensagens, o que você anexa e os trechos de notas que o Vault Q&A e o agente usam. Nada vai pra nós. A lista completa está em [Declarações](#declarações).
Quais modelos são grátis?
Cada provedor tem a sua regra. A lista de modelos nas Settings mostra o limite ao lado de cada modelo grátis, e **Usage › Left today** mostra o que sobra hoje.
- **Google Gemini:** a cota grátis cobre os modelos Flash (2.5 e 3.x, inclusive Lite, Live e TTS), o 2.5 Pro, os embeddings e o Gemma, num projeto sem cobrança ativada. Em troca, o Google pode usar o que você manda pra melhorar os produtos dele. Geração de imagem (Nano Banana incluído), 3.1 Pro preview, Veo e Lyria são só pagos.
- **OpenRouter:** modelos com preço zero, marcados `free · 50/day`. Eles dividem 20 pedidos por minuto e 50 por dia por chave, ou 1.000 por dia depois que a conta compra US$ 10 em créditos. Preço zero no catálogo não basta: o Lyria do Google aparece com 0 mas cobra por clipe, então não é marcado como grátis.
- **NVIDIA NIM:** só os modelos que a NVIDIA marca *Free Endpoint* (20 dos 81 modelos hospedados em outubro de 2026), pra desenvolvimento e teste, até 40 pedidos por minuto. O resto do NIM é pago.
- **OpenAI:** algumas organizações ganham tokens grátis todo dia se compartilharem as entradas e saídas da API com a OpenAI, que usa isso pra melhorar os modelos dela. Nos tiers de uso 1–2 são 250 mil tokens por dia nos modelos principais e 2,5 milhões nos pequenos; nos tiers 3–5, 1 milhão e 10 milhões. Passou disso, o uso é cobrado. A conta precisa ter saldo, modelos de imagem nunca contam, e a elegibilidade aparece em Data controls › Sharing.
- **Ollama:** qualquer modelo local. O único limite é a sua máquina.
Posso manter outros plugins de IA instalados?
Pode. O AXXA roda no próprio painel, os estilos dele ficam presos a esse painel, e ele não depende de outros plugins nem os substitui.
Como reporto um bug?
Use o [formulário de bug](https://github.com/axxalab/axxa-agent/issues/new?template=bug_report.yml). Plataforma, versão do Obsidian e os passos pra reproduzir aceleram muito a correção. Perguntas vão pro [Discussions](https://github.com/axxalab/axxa-agent/discussions).
Mais: effort, uso e custo
- **Effort** (Low a Max) regula o quanto o modelo trabalha: tokens máximos, limite de voltas do agente, temperatura, chamadas de ferramenta em paralelo, novas tentativas e quanto do vault entra no contexto. Cada nível é ajustável em Settings.
- **Usage** lê as conversas salvas e estima o gasto em dólar por provedor, modelo, modo e dia, com um mapa de 30 dias. O relatório exporta em PDF, Markdown ou HTML.
- **Left today**, no topo do Usage, mostra o que sobra hoje em cada cota grátis e quando ela volta: os pedidos grátis do OpenRouter, lidos ao vivo da sua chave (então contam qualquer app que use a chave); os tokens da OpenAI pelo compartilhamento de dados e os pedidos do tier grátis do Gemini, contados pelo AXXA neste aparelho (o Google não publica os limites do Gemini, então você digita o de cada modelo a partir do AI Studio); e os pedidos de hoje no NVIDIA NIM, que não tem teto diário. A contagem é um registro local, guardado no `data.json` do plugin; o AXXA nunca manda ele pra lugar nenhum.
## Roadmap
- **Agora:** estabilidade nos seis provedores, e o agente com modelos locais do Ollama.
- **Depois:** PDFs no Gemini, NIM e Ollama; um modo Coder com prévia das diferenças.
- **Mais adiante:** conectores MCP (Notion, Linear, GitHub); extras pagos opcionais, como sincronização entre aparelhos e transcrição automática de mídia.
Ideias e votos ficam em [Discussions › Ideas](https://github.com/axxalab/axxa-agent/discussions/categories/ideas).
## Feedback e comunidade
- Achou um bug? [Reporte aqui](https://github.com/axxalab/axxa-agent/issues/new?template=bug_report.yml).
- Tem uma pergunta? [Pergunte no Discussions](https://github.com/axxalab/axxa-agent/discussions).
- Fez uma skill útil? Skills são arquivos `.md`, então compartilhe a sua no Discussions.
- Se o AXXA te ajuda, uma estrela no GitHub ajuda outras pessoas a acharem ele.
- Quer apoiar com dinheiro? [Patrocine no GitHub](https://github.com/sponsors/rafaelpsyik), por mês ou uma vez só. Não libera nada: tudo continua grátis. Outros jeitos de ajudar estão na [página de apoio](https://agent.axxalab.com.br/pt/apoiar).
## Licença
**GPL-3.0-or-later**, veja o [LICENSE](LICENSE). Use pra qualquer coisa, inclusive no trabalho, e faça fork à vontade; se você distribuir uma versão modificada, publique o código dela nos mesmos termos. Os logos dos provedores vêm do [lobe-icons](https://github.com/lobehub/lobe-icons) (MIT) e estão creditados no [NOTICE.md](NOTICE.md).
© 2026 AXXA Lab™.