**苏格拉底学习法,深度学习任何一本教材**
**中文** · [English](README.en.md)


---
> 在 Obsidian 里划中一段,这个插件让你践行**苏格拉底学习法**。践行它意味着
> 下面两件事。
>
> **你可以不断追问。** 你尽管问这本书。疑问会被当场解答,还可以写回你的笔记,
> 不会丢掉。只要你想,任何一个知识点都能吃透。
>
> **苏格拉底式提问。** 它反过来不断问你,对着你刚划中的那段,把还没想清楚的
> 地方问出来,让你对这个知识点的理解再往下压一层。
**目录**
[为什么需要它](#1--为什么需要它) ·
[它到底怎么用](#2--30-秒看明白它干什么) ·
[核心功能逐个上例子](#3--核心功能逐个上例子) ·
[系统设计](#4--系统设计) ·
[装 · 用 · 隐私](#5--装--用--隐私) ·
[开发与测试](#6--开发--测试--许可) ·
[Future Works](#7--future-works) ·
[最近的版本](#8--最近的版本)
---
## 1 · 为什么需要它
苏格拉底是一个 Obsidian 插件。装上之后,你在笔记正文里划中一段,右边侧栏就以这一段为
话题跟你聊下去;聊出来的结论,它可以写回原文那一段。它只认真对待一件事:一个人啃一本
长手册,书很厚,作者不在场,读者只有你自己。收集灵感、润色文章这些它不做。
这件事的起点是一本 **13083 行、626 KB** 的技术手册,一个人写的,也只有一个人在读。
这种书跳着看没有意义:每一关都压在上一关的结论上,第 7 关里一句「所以这里必须先 read」,
理由埋在第 2 关某个决策的第三层里。真正折磨人的从来不是看不懂,而是卡住的那一刻
**没人可问**。
通用聊天机器人补不上这个位置。它没读过你这本书,你贴一段进去,它给的是一段四平八稳的
解释,正确,但和你手里这本书没有关系。它不知道这个概念在第 2 关是怎么铺垫的,不知道
作者在第 4 关的决策②里已经否掉过一个更朴素的做法,也不知道你三分钟前才刚问过一个
几乎一样的问题。
要把这个位置补上,这个插件跟的是**苏格拉底学习法**。苏格拉底几乎不讲课:他坐在
对方旁边,针对对方刚说的、刚读到的那一句追问,直到对方自己看见自己没想清楚的
地方。他不给答案,答案是被问出来的。你以为自己跟上了,一问就知道没有;你不必
先组织一整段讲解,只要接住那一个问题,问题本身已经圈定了该想哪一块。
更常被拿来自学的是**费曼学习法**。它的做法是:挑一个概念,用自己的话讲给一个
假想的外行听;讲不下去的地方就是没懂的地方,回去补,再讲一遍。它靠的是输出——
你得自己开口讲。懂了八成之后拿它查漏,很管用。但它有一个入口:你已经能开始讲。
啃长手册最难受的时刻,恰恰卡在这个入口之前。材料刚铺到一半,上一关的结论还没在
脑子里站稳,你甚至不知道该拿哪一块去「讲给别人听」。空白纸不会先问你一句。费曼法
你自己就能做,一张纸就够;苏格拉底法一直缺的是那个坐在旁边的人。对一本关关相扣
的教材来说,你缺的不是讲台,是那个在你停下的地方问一句的人。这一点费曼法够不着:
卡住的那一刻就能用得上,不必等自己先变成老师。
所以它全部的设计都从一句话长出来:**让一个真读过这本书、而且知道你读到哪儿了的人,
坐在你旁边**。既然是坐在你旁边的人,默认动作就不该是把答案端上来。默认那枚芯片叫
`socratic`,职责是先别揭晓、反过来问你一个问题——一个默认反问的学习工具和一个默认给
答案的学习工具是两种东西,后者替你想完了,前者逼你自己先想一遍。
另外两件事它不靠提示词自觉,**靠代码兜住**。模型想改你笔记里的任何一段,必须在更早的
一轮里真的读过那个文件,这笔账由执行层记,声称读过不算数。会话、快照、深挖账本则全在
你自己机器上的本地目录里,仓库里没有任何埋点。出网的是发给你在设置里填的那个模型节点、
插件升级后重新拉起服务时取一份新 sidecar,模型调用 `search` 时发给 DuckDuckGo / Bing /
Wikipedia 的关键词,以及模型调用 `fetch` 时向那个 URL 发的 GET(只接受公网 http/https)。前两条各自拦在哪一行,[第 4 章](#4--系统设计)有逐条的实现。
下面所有例子跑的都是另一本书:仓库 [`docs/demo/`](docs/demo/) 里那本 1405 行的
《从零手写 DQN · 强化学习通关手册》。它随仓公开,你可以导进自己的库把后面每一段对话
重跑一遍——这份 README 不打算让你只看着截图相信。
---
## 2 · 30 秒看明白它干什么
一次完整的用法是五步,全都发生在你那篇笔记和右边那条侧栏之间:不用离开 Obsidian,不用
开终端,也不用先把整本书喂给谁。前四步只是读和问,只有最后一步会碰你的磁盘,而且必须
你亲手点头它才碰。
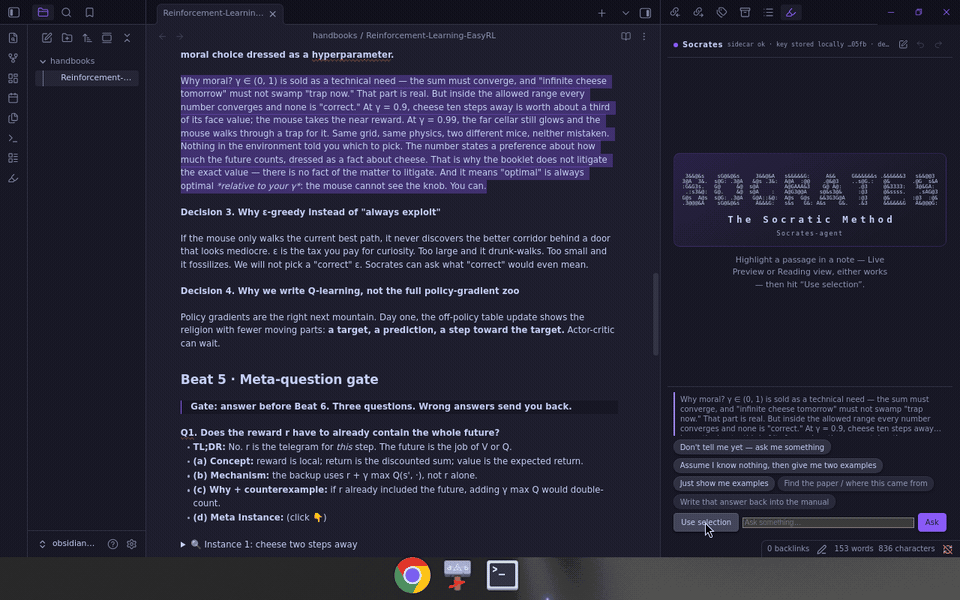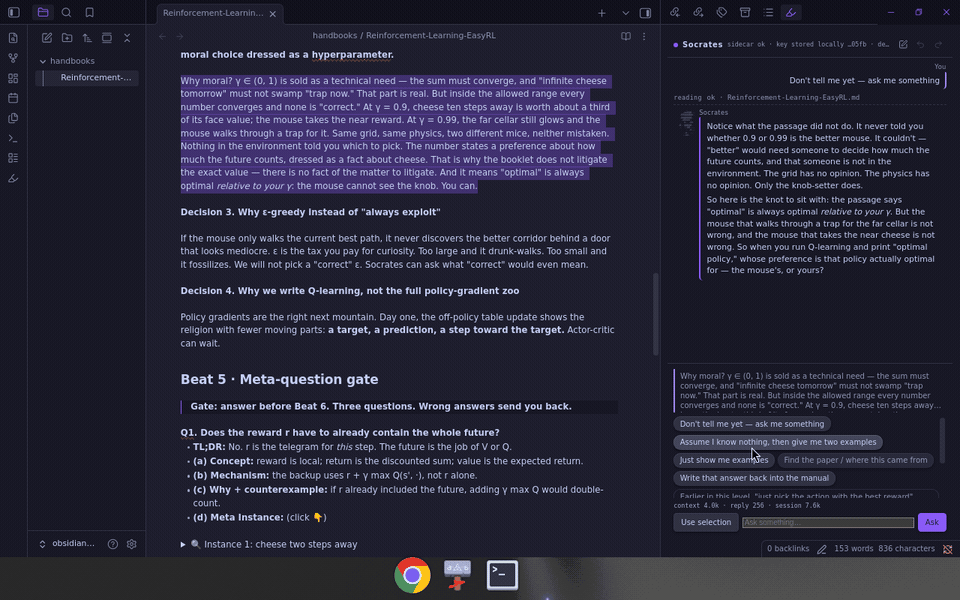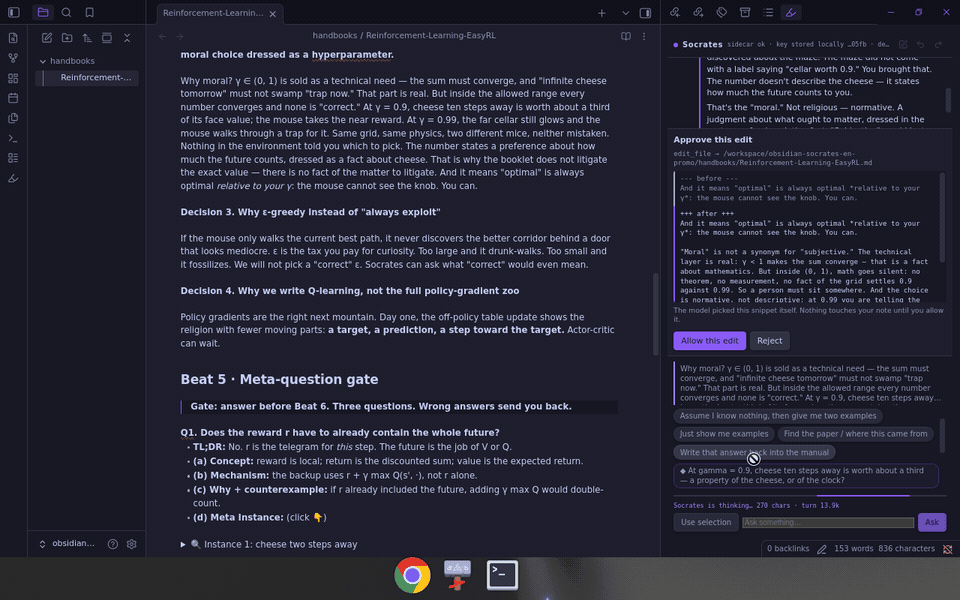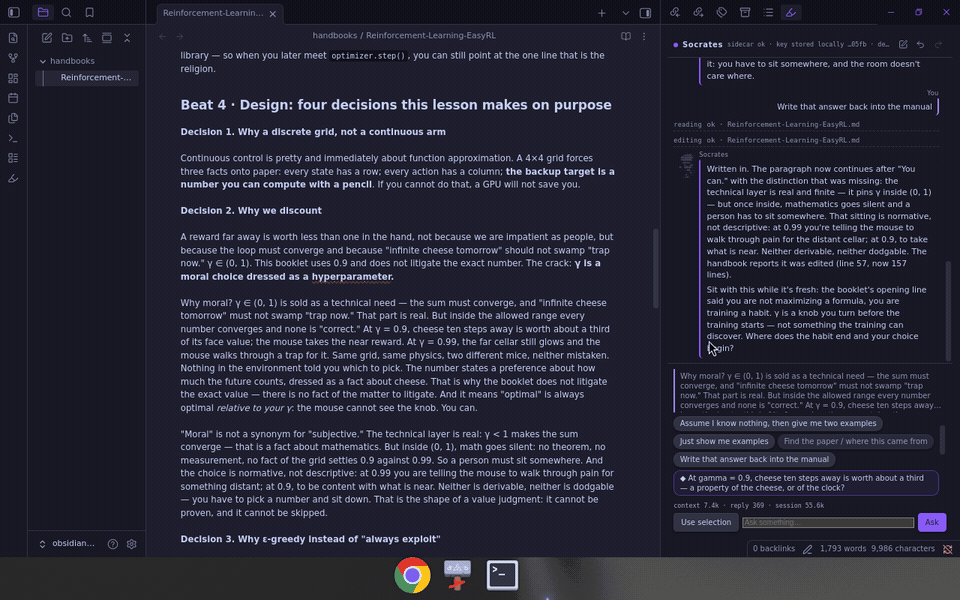
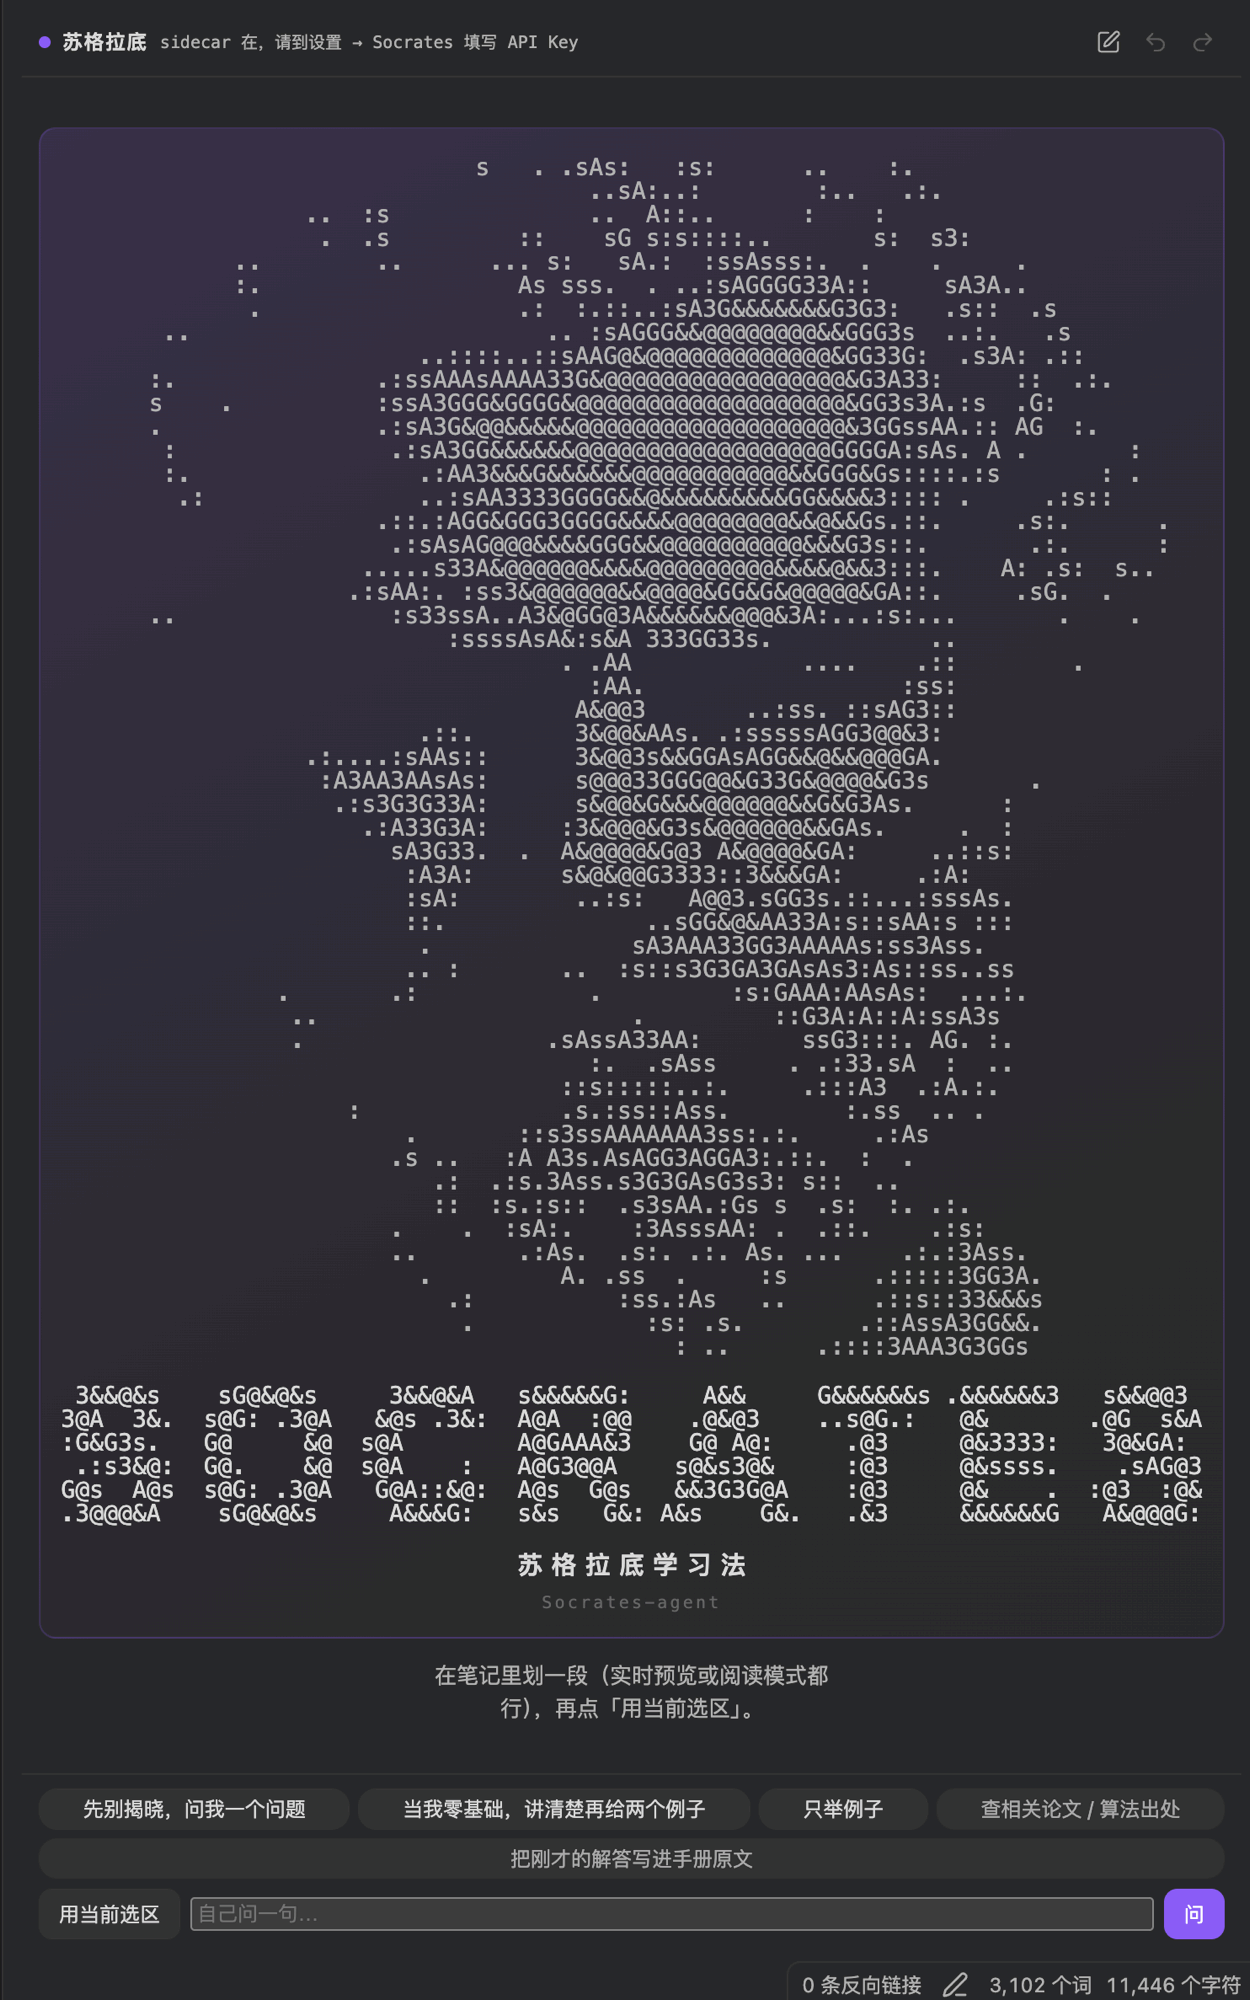
1. 在笔记里划中一段。
2. 打开侧栏点「用当前选区」(命令面板里有同名命令),再点一枚芯片(先别揭晓 /
当我零基础 / 只举例子),或者直接打字问。
3. 他先读你的笔记,再回答你,或者反过来问你一个问题。
4. 与此同时,后台另起一条线(下面叫「深挖 ◆」)去读同一本书的别处,攒几个更深的问题
存进池子,每轮最多放一条出来抛给你。
5. 想把解答留在笔记里,他会提议一处编辑;你点「允许」,磁盘上才会动。
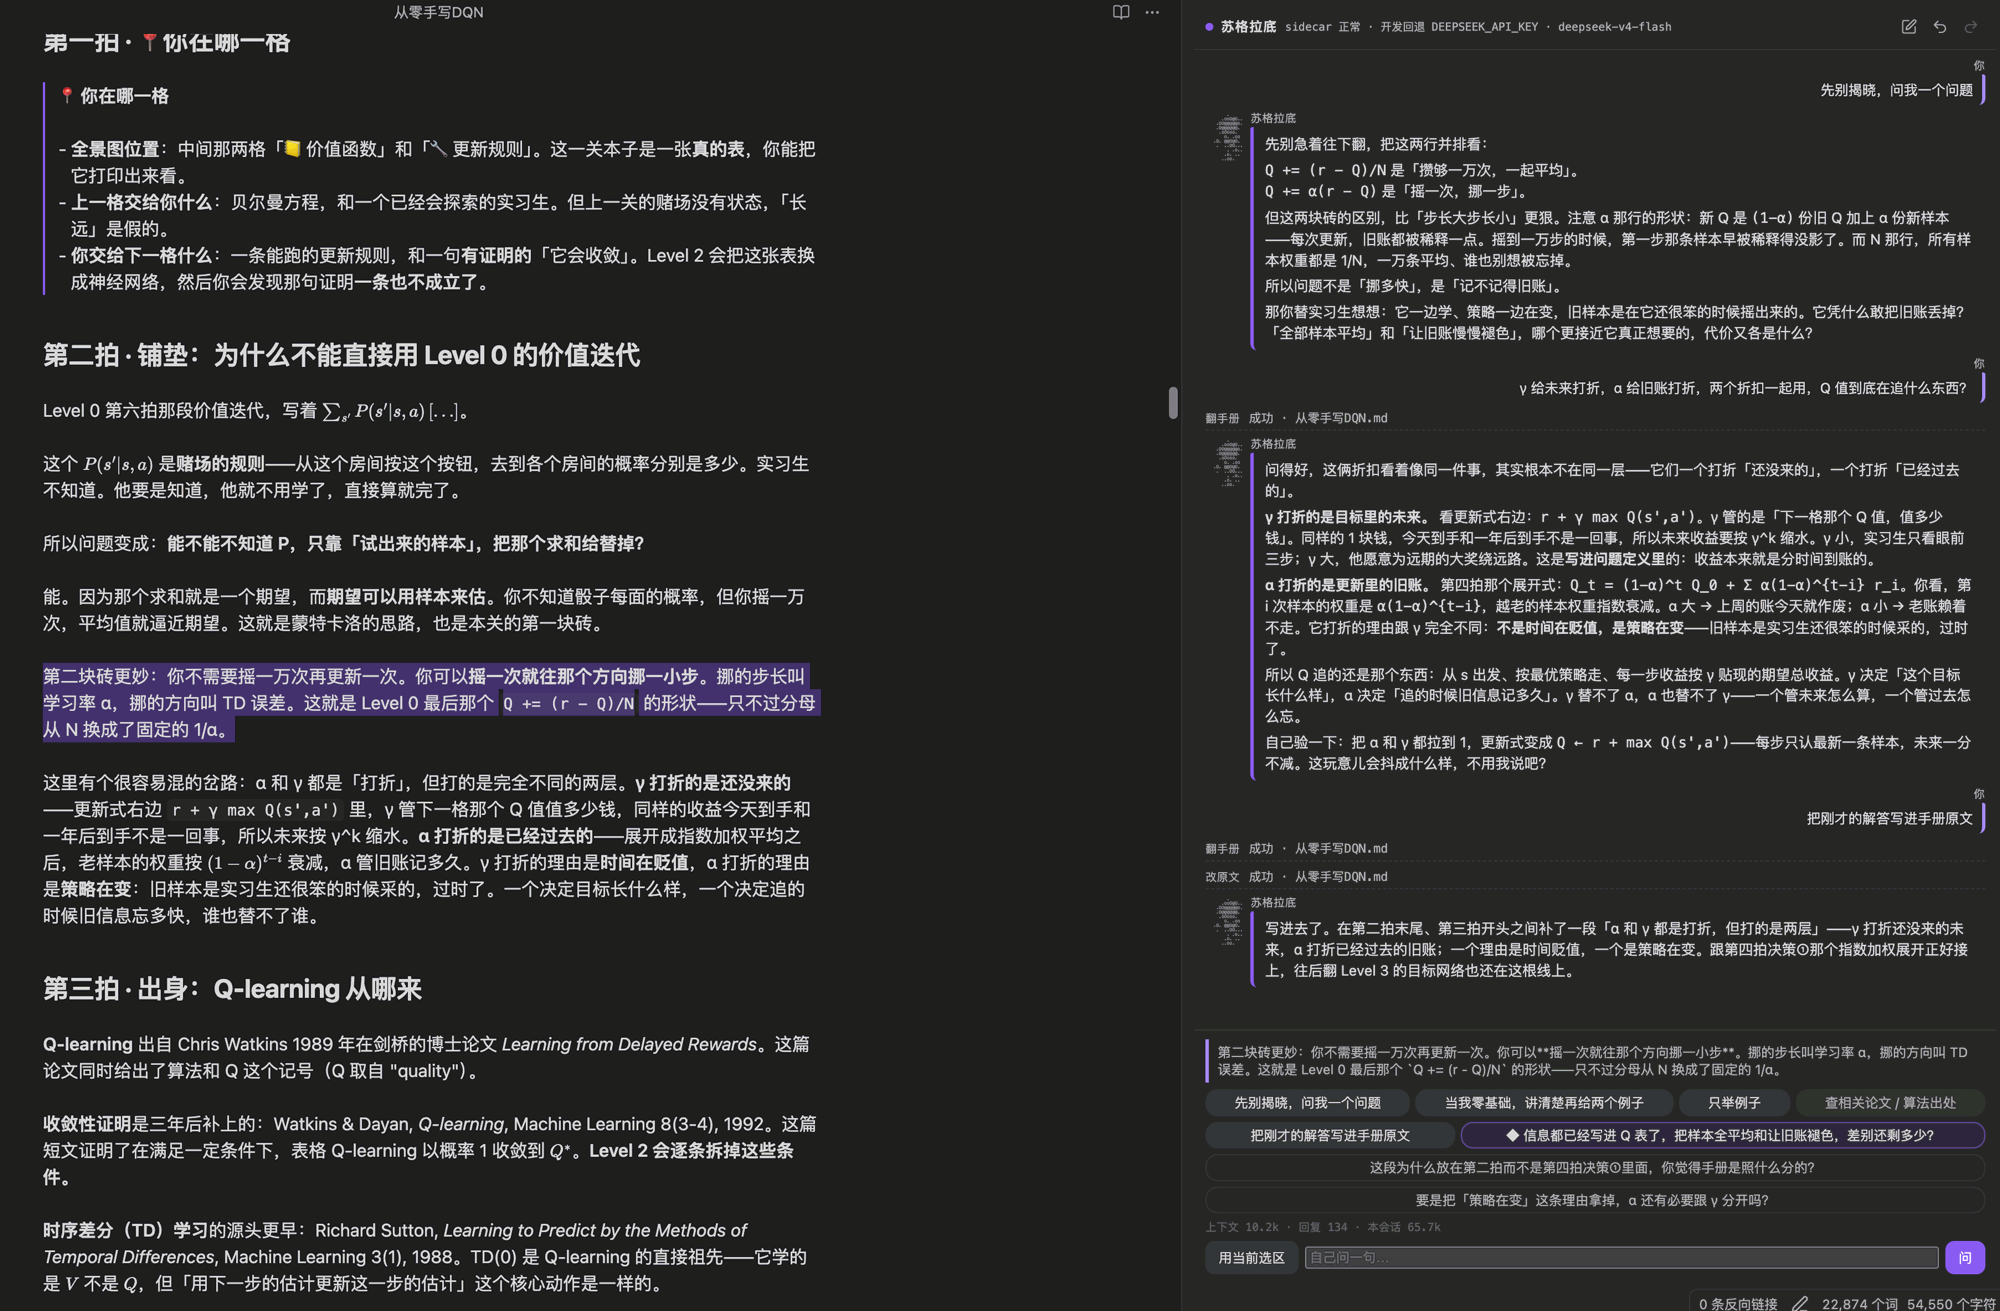 这一节和下一节的界面图都是真跑出来的,没有摆拍。界面语言跟随 Obsidian,图里是中文界面。
状态行上那句「开发回退 DEEPSEEK_API_KEY」是从源码树跑才有的字样——你正常安装之后,
那里显示的是你在设置页填的那个节点。
**它不是对任意笔记都一样好用。** 主对话对任何 Markdown 都能跑;但后台深挖要在书里下锚,
需要教材按八拍体例写,每一关得有「第三拍 · 出身」「第七拍 · 实操代码」这样的小节。少了
那些小节,五条深挖轴会直接死掉一条,其余四条照常出题。
[`docs/demo/从零手写DQN.md`](docs/demo/从零手写DQN.md) 是一份可以照抄的样板,为什么非得是
这个体例,见 [4.9 教材无关](#49--教材无关)。
---
## 3 · 核心功能逐个上例子
**场景**:你在读《从零手写 DQN》的 Level 3,划中了第四拍的**决策① 「为什么非要两个网络——
一个冻着、一个在更新」**(第 954–964 行)。这一段把答案拆成了三层:数学、动力学、工程。
以下所有回答都来自 **`deepseek/deepseek-v4-flash`**(经 OpenRouter 节点),
跑在一个隔离的 **sidecar**(插件在你本机拉起的那个 Python 小服务)上。
换任何一个 OpenAI 兼容的 Chat Completions 端点都能跑——**但除这一个组合之外我没实测过**。
这一章每一段输出都是真跑出来的:原始请求体和 SSE 事件流全存在
[`docs/demo/transcripts/`](docs/demo/transcripts/) 里,每处引文下面都挂着对应的 JSON。
落盘之后只动过一件事——把采集环境的临时绝对路径换成 `/Users/you/…`,除此之外一个字符
没改([说明](docs/demo/transcripts/README.md))。唯一没随仓公开的是
[3.7](#37--两本书之间) 那两段,它们出自作者本机的旧会话,里面全是私人 vault 路径,
那一节的落款自己写着这件事。
### 3.1 · 先别揭晓 `socratic`
**默认那一枚。** 它读你划的那段,然后**不回答**——它去找那段话里你还没意识到的裂缝。
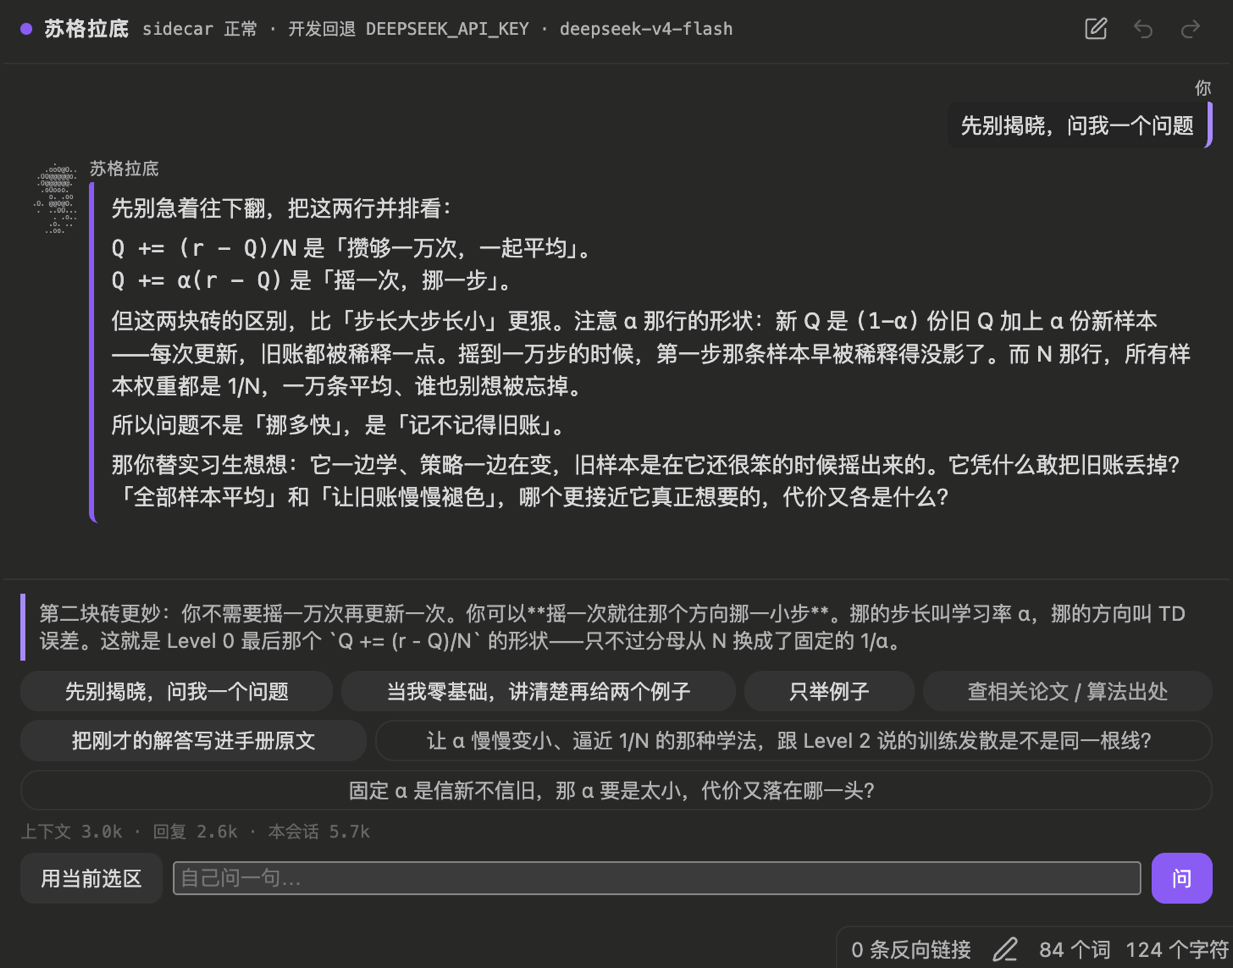
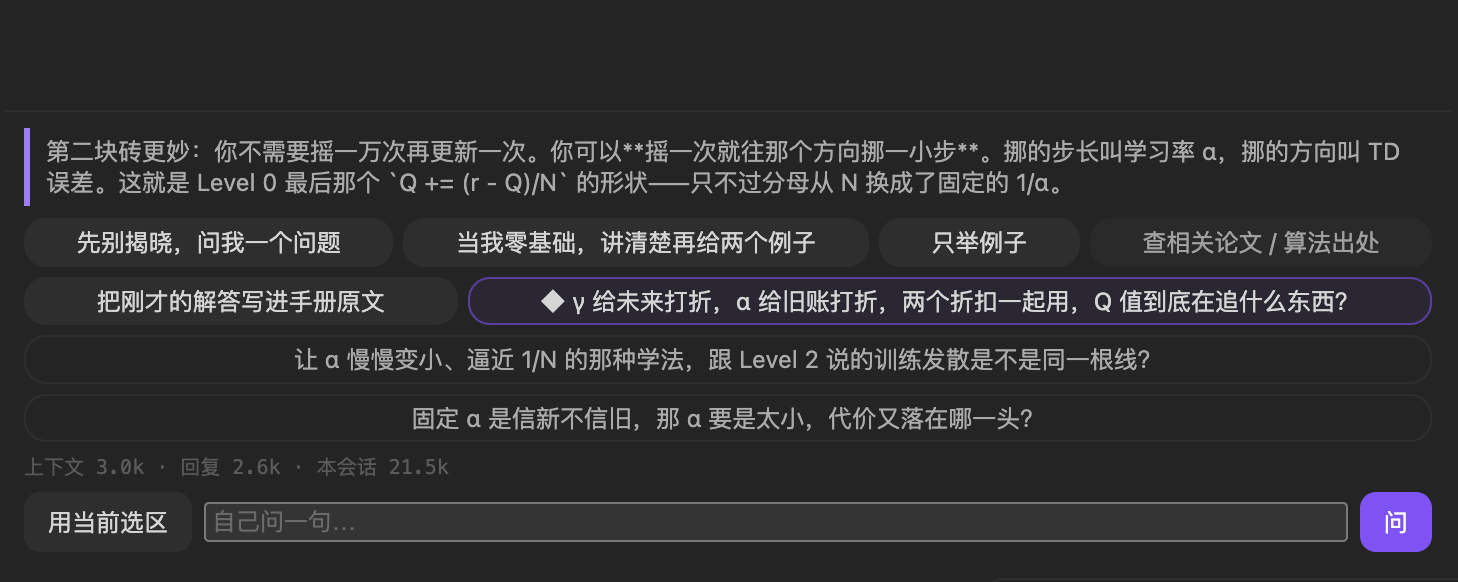 真跑那一次池子里攒了三条,第三条是这样的:
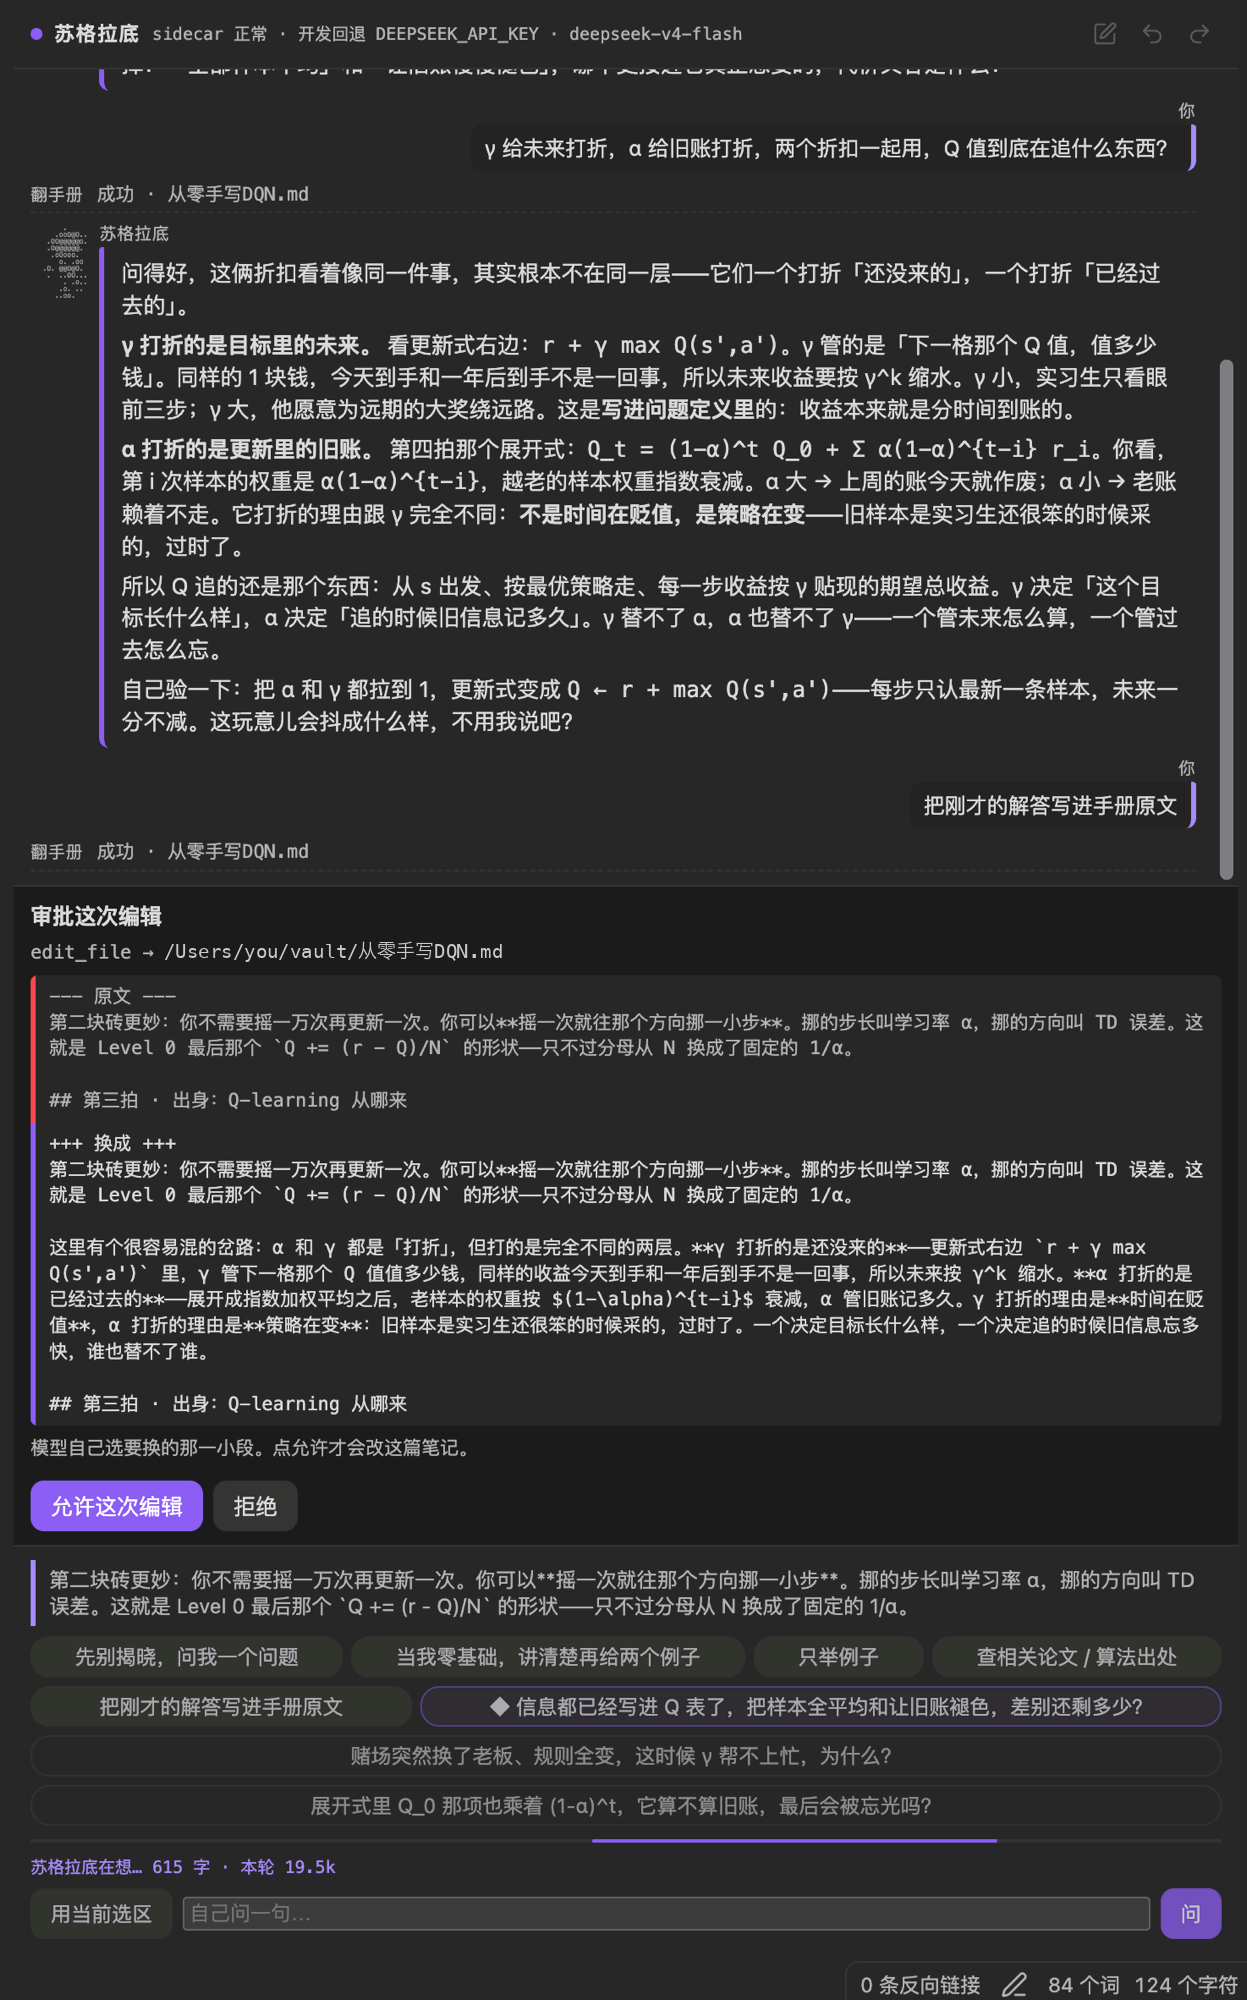
 你说:「把你刚才讲的『为什么要两个网络』那三层,做成一个折叠块,补在决策① 后面。」
它先 `read_file` 读到带行号的原文,**下一轮**才单独提一次编辑。侧栏弹出审批面板,
`old_string` / `new_string` 逐字对照。它提议的是:
```diff
- 这是本关最核心的一问,把它拆成三层:
+ 这是本关最核心的一问。下面从三个层面拆解,你可以按自己感兴趣的顺序读(点击展开):
+
+
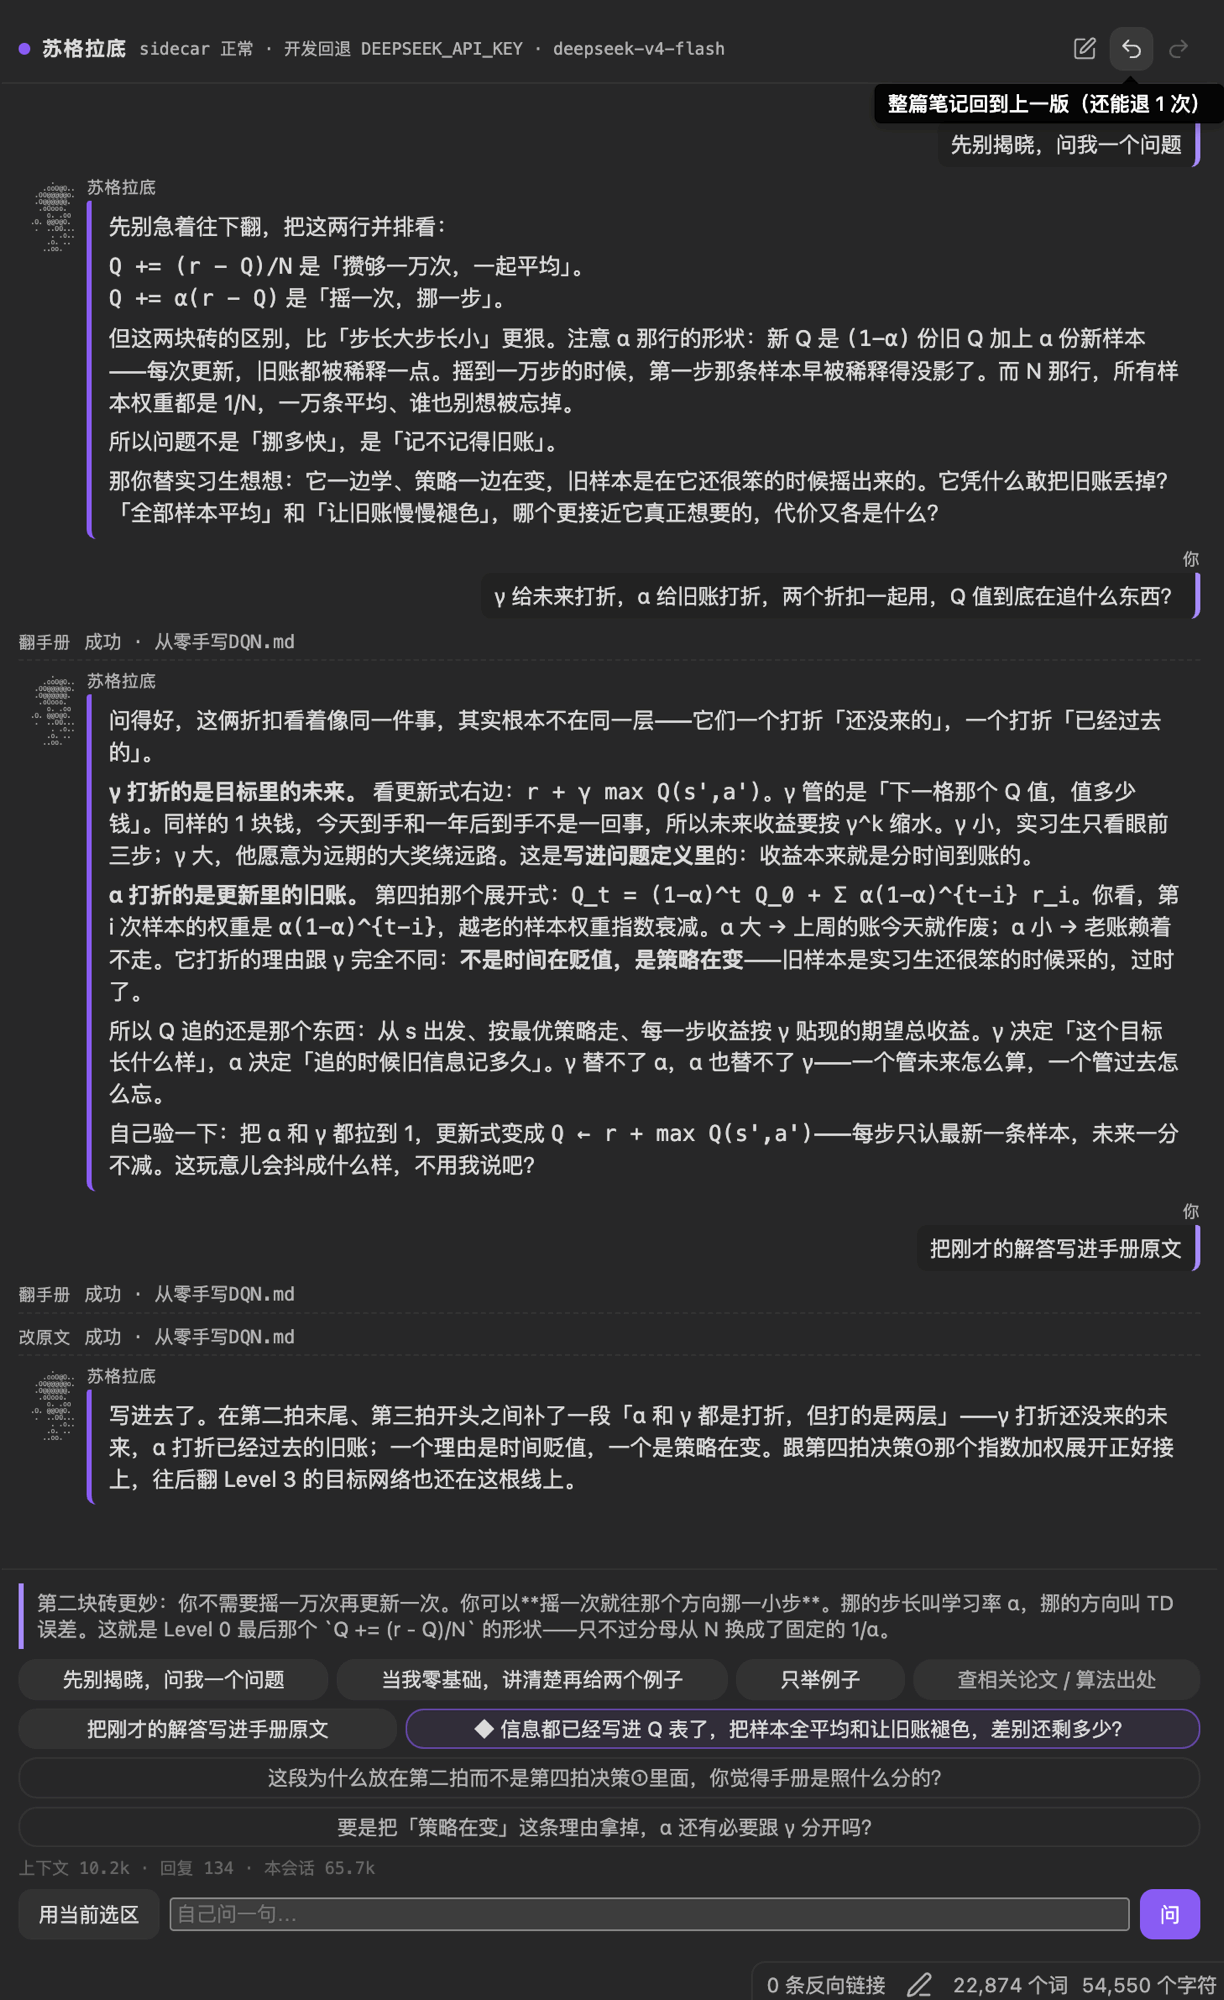 ```
GET /v1/handbooks/dqn-550d425c/snapshots
→ {"can_undo": true, "can_redo": false, "undo_n": 1, "redo_n": 0}
POST /v1/writeback/rollback
→ {"ok": true, "restored_from": ".../snapshots/20260822T015739533075Z-pre-edit.md"}
```
**它按整篇还原,不是只撤你划的那一段。** 因为模型提议的编辑可能同时动了好几处,
按选区回退会留下一个半新半旧的文件。
undo + redo **一共只留 20 版**(`pen/config.py:57` `SNAPSHOT_KEEP = 20`)——
这不是一个无限的历史,是一个能兜住「刚才那下点错了」的深度。
### 3.7 · 两本书之间
书架上不止一本书的时候,苏格拉底会拿到一份**其他教材的摘要 + 路径**,于是他能翻到另一本。
这件事的价值,看一对**同题对照**最清楚。同一个问题——「另一本讲什么」——问了两次。
**书架接上之前**,他老实认账:
> 好问题,但我得先给你交个底:**另一本《通关手册》我没读到,不能瞎编。**
>
> 我能确认的是手上这本。它名字就写明了——`writeback-fixture.md`,fixture,测试夹具。
> 意思是:这本书的真正用途不是「内容」,是**测试「写回」这条链路**。
>
> 至于那本《通关手册》具体讲什么——你把它的路径给我,我去读一眼再回答你。
> 不读就猜,那是江湖骗子干的事。
**书架接上之后**,同一个问题,他先去读:
> 我先去翻一眼那本《通关手册》的开头,别凭标题瞎说。
>
> `read_file` → `1 # 手搓 SWE Agent 通关手册 v2 · 教材级(全册:开篇 + Level 0~6 + Capstone)` …
>
> 看完了,两本册子不是一套书,是两种东西。
> **《通关手册》是正课。** 目标一句话:让你从零手搓出一个轻量 SWE Agent……
> 整本一个比喻:你是师傅,Agent 是记性为零、胆子极大的实习生。
⚠️ 两段都出自作者本机的真实会话,**没随仓公开**(里面是私人 vault 路径),
所以这是全文**唯一**你没法自己核对的引文。其余每一处引文下面都挂着可点开的 JSON 原文。
**注意「之前」那一版并不是失败。** 他答「我没读到那本书」是**对的**——那本来就是实情。
这就是为什么书架那一整段在只有一本书的时候会**整段不出现**,而不是写一个「(无)」:
写「(无)」等于替模型确认过「没有别的书」,那是替它撒谎。
还有一条:给书名**必须同时给路径**。
> 光给书名,苏格拉底只会去猜文件名。
这句话现在是 `pen/tests/test_tutor.py` 里一条断言的失败提示。
### 3.8 · 账单
```
GET /v1/usage
```
```json
{
"spend": {
"chat": {"calls": 14, "in_tokens": 189275, "out_tokens": 9872,
"cached_tokens": 125440, "reasoning_tokens": 4906},
"probe": {"calls": 4, "in_tokens": 15892, "out_tokens": 6923,
"cached_tokens": 3328, "reasoning_tokens": 5674},
"fold": {"calls": 0, "in_tokens": 0, "out_tokens": 0}
},
"total": 221962, "sessions": 2, "skipped": 0
}
```
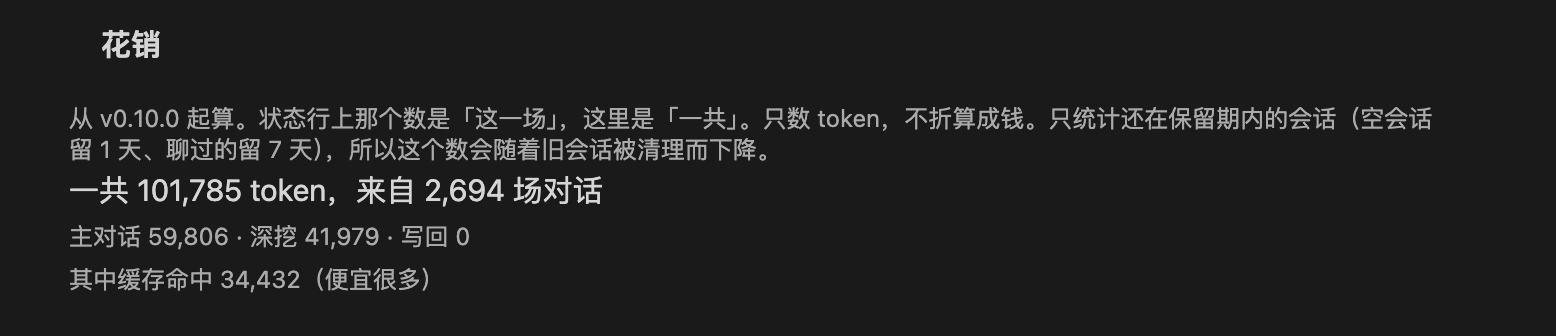 原文:[`10-usage.json`](docs/demo/transcripts/10-usage.json)——上面 3.1 到 3.6 全部跑完之后的真实账单
三笔分开记:`chat` 是你正在聊的那条线,`probe` 是后台深挖,`fold` 是写回时的折叠生成。
**分开记是为了能分开限**——后台超支不该掐掉你正在读的那一轮。
**它只数 token,不折算成钱。** 因为汇率是你的:你填的是哪个节点、哪个模型、
有没有折扣、缓存命中算不算钱,只有你知道。
不过你大概想知道一个量级。上面那 22 万 token,按我跑这一轮时那个节点对
`deepseek/deepseek-v4-flash` 的挂牌价($0.077/M 入 + $0.154/M 出)算:
```
入 205167 × $0.077/M + 出 16795 × $0.154/M ≈ $0.018
```
**不到两美分**,而且这是**上限**——它把 12.9 万个缓存命中的 token 当全价算了。
换前沿模型会贵一到两个数量级。
**这个累计数会往下掉**,别以为是 bug——会话是有保质期的([见 4.8](#48--会话会过期账也跟着走)),
被清掉的那些,它们的账也跟着走了。
### 3.9 · 自己定一枚泡泡
上面那几枚芯片,底下其实都是同一件事:**点一下,往 `[意图]` 段里塞一句话**。
`socratic` 塞的是「别揭晓,先反问」,`explain_zero` 塞的是「当我零基础」。
就这么简单——所以没有理由只让作者写这句话。
设置页 → **自定义泡泡** → 从模板挑一个新建。三个起手模板分别是
「把这段出成一道题」「把解释折进原文」「补一段 LaTeX 风格伪代码」,
复制过来照你自己那本书的体例改:改小节名、改编号规则、改折叠块长什么样。
改完侧栏那排就多一枚按钮,虚线描边,和固定芯片分得开。
最常见的用法是**按你自己的体例往笔记里插内容**。比如让它把问题写进你的题目小节,
并且必须是 `
 Obsidian 插件(TypeScript)、本机 sidecar(Python / FastAPI)、你自己填的那个模型节点,
一共就这三个,中间那条线是 loopback。插件不打作者的服务器,仓库里没有任何 telemetry
端点;sidecar 只绑 `127.0.0.1`,你在设置里填一个非本机地址,`parseListen` 会直接抛
`new Error("not-loopback")`(`src/sidecar.ts:53`),而不是「尽力而为」地警告一句。
模型调用从你的电脑发出去,发到你填的那个节点,任何 OpenAI 兼容的 Chat Completions
端点都行。真正出本机的还有装和升级那两下:插件建 `~/.socrates-pen/venv` 并从 GitHub
和 PyPI pip 安装 sidecar,之后就全在本地。升级那一下有个前提——插件每次启动先 ping 本机
服务,ping 通就直接接上、什么都不下载;只有 ping 不通、要重新拉起时才比对版本号,发现旧
了才照着新版本号再取一份。
### 4.2 · 工具箱里四把
工具箱里是 `read_file`、`search`、`fetch` 和 `edit_file`——**没有 bash,没有 write_file,没有 shell**。
权限也不是一个开关,是三值的:`read_file`、`search` 和 `fetch` 是 allow,自动过;`edit_file` 是 ask,
**每一次**都弹审批;其他任何名字一律 deny,不认识就拒。最后这一条是默认拒绝,不是默认放行,
模型幻觉出一个 `run_command` 来,撞的是墙。
`search` 不用任何钥匙、不接任何搜索 API:sidecar 自己 GET DuckDuckGo 的纯 HTML 结果页(倒了换
Bing),再向 Wikipedia 要一份;三家合起来按规范化 URL 去重、按 Reciprocal Rank Fusion 排好,给模型
「标题 / URL / 摘要」的列表,一次默认 5 条、最多 10 条,尾注写共几条、还剩几条、下一段的 offset;
同一个 query 十分钟内翻页从缓存切,不再打引擎。`fetch` 给定一个 http 或 https 的 URL,GET 那一页,
去掉标签,按段落编号交给模型,offset / limit 和 `read_file` 一个用法,续读同一页不重新下载。
只接受公网地址,内网、本机、`file://` 一律拒;解析出 IP 之后按这个 IP 去连,Host / SNI 仍用原来的名字。
### 4.3 · read-first 是一道硬闸
要改哪一段,必须在**更早一轮**成功读过那个文件;同一批 `tool_calls` 里先 read 再 edit
也照样拦。这条容易被当成过度设计,其实不是——同一批里那两个调用的参数是**同时**生成的,
写 `edit_file` 的 `old_string` 时,`read_file` 的结果还没回来。那仍然是猜,只是猜得比较
像。被拦下来时模型收到的不是一句「拒绝」,是一段说明怎么做才对的话:
> 错误:edit_file 之前必须先成功 read_file 同一路径。请先 read_file 看准带行号的原文
> (格式 N\t原文),下一轮再单独调用 edit_file(不要和 read_file 写在同一批 tool_calls 里)。
> old_string 必须是去掉行号前缀后的纯原文。
`pen/agent/permissions.py:7` `READ_FIRST_MSG`
### 4.4 · 沙箱有两套根,读和写不是一回事
**写**只允许改**登记过的那一篇**(`assert_write_target`:目标必须逐字等于登记时的原文路径)。
**读**可以放宽到白名单里的根。`.git` / `.obsidian` / `.env*` 一律拒,两边都拒。
**这两套根宽窄差得很远,得说清楚。** 从 Obsidian 里用,读根是**整个库根**
(外加 sidecar 自己那个根:`read_roots()` 返回的是 `[REPO_ROOT, *extra_roots]`,
`REPO_ROOT` 永远在里面——pip 装的时候它是 site-packages)——
插件登记教材时把 `vaultRoot(app)` 一起发过去(`src/views/PenView.ts:849` →
`pen/libraries.py` 的 `meta.allow_root` → `pen/tutor.py:69` 的 `read_roots()` →
`pen/sandbox.py` 的 `assert_readable`),不需要你手动放宽。实测:登记 `book.md`
之后 `read_file("私人/日记/2026.md")` 是**放行**的。
实际不会发生,是因为提示词只告诉了它当前这篇和书架那几本——**那是行为,不是边界**。
写那一侧才是真闸:连书架上的别本都改不了,只能改登记过的那一篇。
书架的可见性用的是**读根**,不是全局允许根。这条差别听起来很细,但方向很明确:
> 印一条苏格拉底读不到的路径,比不印更糟。
因为那会让他试着去读、失败、然后当着你的面编。
### 4.5 · 后台深挖是一条任务队列
 **为什么要另起一层。** 一开始追问是搭车产出的——让模型在回答的末尾顺手写两条
``。问题是那两条永远纠缠在刚讲过的细节上(「echo 加不加引号」),
而读者真正想问的是架构层面的东西:搭车的追问,视野被那一轮的上下文锁死了。所以深挖
被拆成独立的一层,有自己的 prompt、自己的预算、自己的账本。
 三个 token 上限**分开记也分开限**:主对话一个、后台深挖一个、跨书阅读一个。分开的理由
很实际——后台超支不该掐掉你正在读的那一轮。三条上限默认全是 0,0 就是不限,判据只有
一句 `cap > 0 and (spent + max(0, headroom)) >= cap`(`pen/meter.py:167`),「0 = 不限」
的全部实现就是 `cap > 0` 这一半。
超限不报错。它给模型追加一句让它收敛的话,不是抛异常,你看到的是一个短一点的回答,
不是一个红色感叹号。**主对话那个不是硬上限**:到线之后还会再出一次答案,因为那一轮
已经开跑了;设置页上就是这么写的,这里也照样写。
### 4.8 · 会话会过期,账也跟着走
| 类型 | 判据 | 留多久 |
| --- | --- | --- |
| 空会话 | `len(messages) <= 1` | **1 天** |
| 聊过的 | 其余 | **7 天** |
| 挂着审批的 | `pending.id` 非空**且不是空会话** | **30 天** |
为什么需要这个:清理上线之前实测,会话目录攒到 **3389 个文件 / 10.4 MB**,
其中 **3371 个是空的**——每划一次词就建一场,绝大多数没等到第一句话就被下一次划词换掉了。
第三档那个「且不是空会话」是后来收紧的。第一版写成「有 pending 就永不删」,
那是一条**无界豁免**:任何带 `pending` 键的文件从此占着盘,清理再怎么跑都动不了它——
**那正是这次要治的病本身**。
`pen/retention.py`,模块头有完整的实测记录
### 4.9 · 教材无关
它对任何 Markdown 教材都能用,书名从**你那篇笔记的第 1 行 H1** 注进去。这一句是
`SYSTEM_PROMPT` 的第一句话,也就是每一场会话 `messages[0]` 的全部内容,建场那一刻就
固化并落盘——书名要是写死在里面,模型一上来就被告知它在读一本它没在读的书。真跑那一次
落盘的 `messages[0]` 第一行是:
> 你是苏格拉底,坐在读者旁边,正在带人读一本叫《从零手写 DQN · 强化学习通关手册(全册:开篇 + Level 0~3 + Capstone)》的通关手册。
全文里 **`SWE` 出现 0 次**。
原文:[`02b-system-prompt.json`](docs/demo/transcripts/02b-system-prompt.json)
书名要注两次,因为提示词有两条路。后台深挖走的是另一份,它的 user packet 里给了位置、
原话、苏格拉底刚讲的、足迹、书架、已经问过的题,唯独不说这是哪本书——模型只能从关号、
拍名和材料往回推,于是照着提示词里那五个示范问题的名字走,而那五个例子取自别的书。
那一路现在也注书名,走的是和 `messages[0]` 同一套清洗:
```
[你在带读哪本书]
《从零手写 DQN · 强化学习通关手册(全册:开篇 + Level 0~3 + Capstone)》
(下面所有材料都出自这本书。它讲什么,看材料——别从别的书上推。)
```
`pen/probe.py:build_user_message`
**但八拍体例留下了,而且是故意的。** 「第三拍 · 出身」「第五拍 · Meta Question 门禁」这些
不是那本书的内容,是**格式契约**:`vs_real` 轴要求锚点落在「出身」那一拍,`examples`
要求例子名对得上「第七拍」。教材体例和深挖算法是咬合的,你的书按这个格式写,深挖才有
地方下锚,[`docs/demo/从零手写DQN.md`](docs/demo/从零手写DQN.md) 就是一份可以照抄的样板。
### 4.10 · 一轮对话,从划词到落字
 ### 隐私与网络
**它不做什么。** 不索引、不遍历、不上传,它不会扫你的库,也不会把笔记发到任何地方。
实际发生的读取只有两种:你划词的那一篇,和你放上书架的那几本。插件默认只访问
`http://127.0.0.1:8765`,不向作者汇报任何东西;会话、快照、深挖账本全在你自己机器上的
`~/.socrates-pen/` 下。
**但那是行为,不是沙箱保证。** 只读到那两种,是因为提示词里只告诉了它这些。沙箱真正的
读边界是**整个库根**(`.git` / `.obsidian` / `.env*` 除外),库根由插件在登记教材时一并
发过去(`src/views/PenView.ts:849` 把 `vaultRoot(app)` 发给 `POST /handbooks/import`),
不需要你手动放宽。你在对话里直接报出一个路径,它就能读到。写的边界严格得多,见
[4.4 沙箱有两套根](#44--沙箱有两套根读和写不是一回事)。
**写盘那一侧才是真闸。** 任何编辑都要你先批准,不批准就是一个字都不落盘,只问不写是
完全正常的用法。兜住这件事的是审批闸,不是「你没点那枚写回芯片」——在 `free` 里直说
「帮我在那段后面补一句」,模型同样会走到 `edit_file`(`pen/session.py:64`),侧栏照样
弹审批,[3.5](#35--写回原文和那道审批闸) 那段拒绝演示用的正是 `free` 芯片
([`08b-approve-deny.json`](docs/demo/transcripts/08b-approve-deny.json))。真正的闸在
`pen/agent/permissions.py:18-19`:`edit_file` 恒为 `ask`,对每一枚芯片都成立。
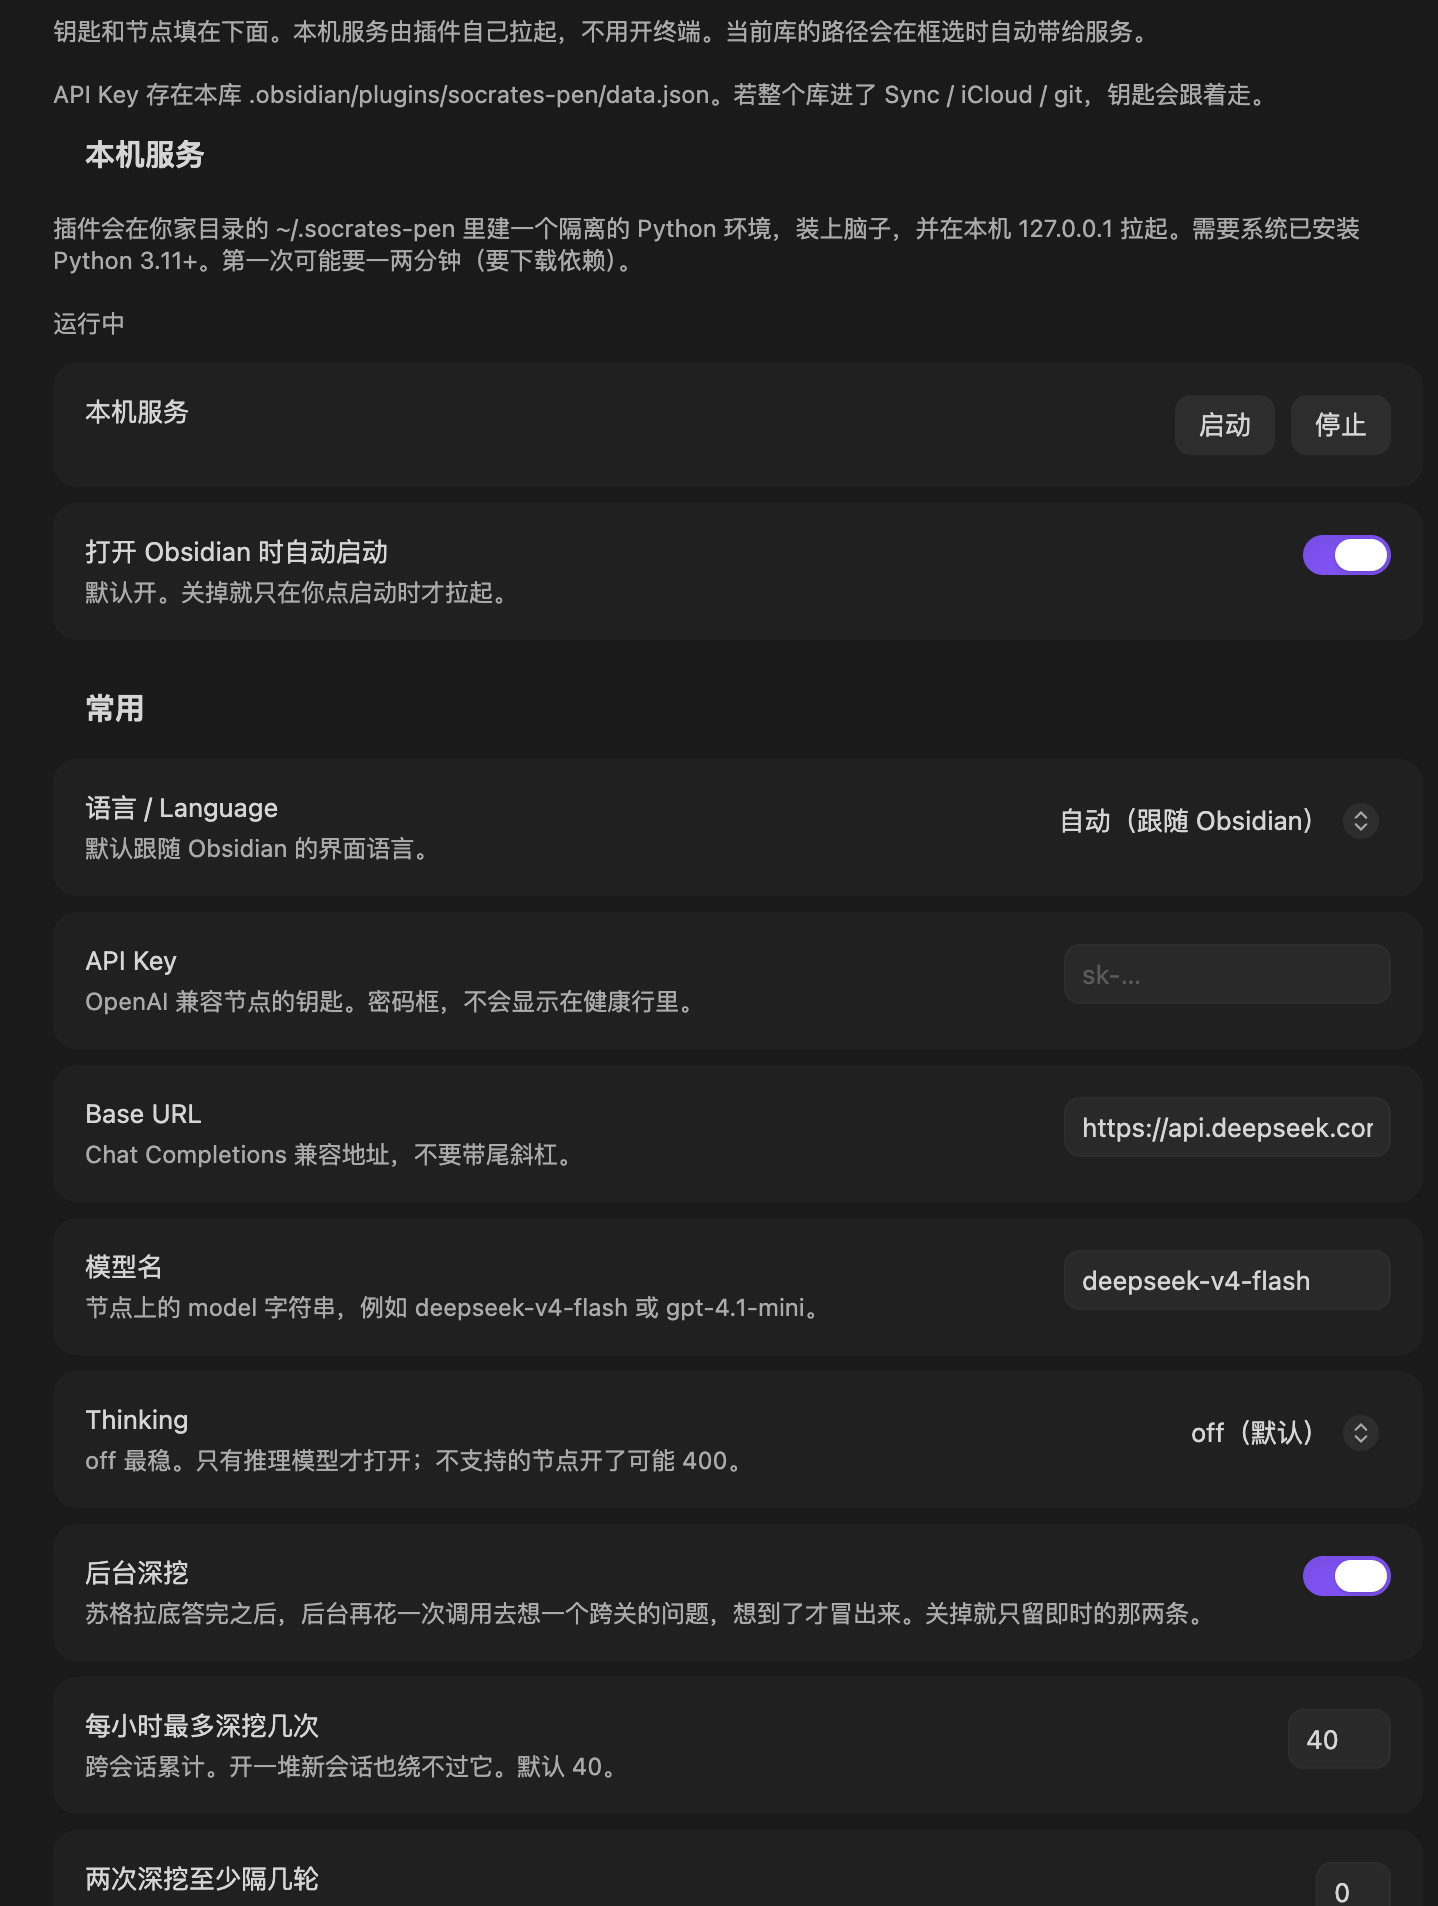
**剩下三件要你自己留意。** 一,API Key 只存本机 sidecar 家目录的 `~/.socrates-pen/llm.json`
(权限 0600),**不写进这个库**——Sync / iCloud / git 带不走它;从旧版本升级时会把钥匙从
`data.json` 自动迁过去并抹掉。若这个库在旧版本时代被同步或提交过 git,历史里的那把钥匙
清不掉,请去服务商**轮换一把**。开发场景也可以不用设置页:给 sidecar 留 `OPENAI_API_KEY`
或 `DEEPSEEK_API_KEY` 环境变量(或源码树里的 `.env`)同样有效。二,网络有四处:装的时候从
GitHub 和 PyPI 拉 sidecar 和依赖到 `~/.socrates-pen`,插件升级后重新拉起服务时会再取一
次;模型调用由这个本机进程发到你填的那个节点;模型调用 `search` 时会把关键词发给
DuckDuckGo / Bing / Wikipedia;模型调用 `fetch` 时会向那个 URL 发 GET
(只接受公网 http/https,内网和本机一律拒绝)。三,禁用插件默认不会停掉
sidecar,那个 Python 进程还在跑,下次启用能立刻用,多个库也共用它;不想让它常驻的,
设置里有「退出后保持本机服务运行」,关掉之后退出 Obsidian 会停掉由本插件自己拉起的
那只(别人拉起的从不碰)。设置页那个「停止」会停掉配置端口上正在听的进程——包括
上次留下的、别的库共用的、旧版残留——并告诉你停的是哪一种。health 里带着 pen 版本,
和插件对齐才标「运行中」;旧服务占着端口时要先停再启动升级。
### 装不上 / 起不来
第一次启用要建 venv 再 pip 安装,这一步最容易出事。按顺序查:
1. **设置页最上面那一行说什么。** 显示「未运行」就先点**启动**,错误会直接印在那里。
2. **本机 Python 够不够新。** 终端里 `python3 --version`,要 3.11 或更高;macOS 自带的
可能还是 3.9,去 [python.org](https://www.python.org/downloads/) 装一个。
3. **venv 建坏了就整个删掉重来。** `rm -rf ~/.socrates-pen/venv`,回设置页点启动它会重建;
`~/.socrates-pen/` 下还存着你的会话和快照,**别删整个目录**。
4. **端口被占。** 默认 `127.0.0.1:8765`,`lsof -nP -iTCP:8765 -sTCP:LISTEN` 看是谁占着。
5. **还是不行。** 开 Obsidian 的开发者控制台(`Ctrl/Cmd + Shift + I`)看报错,连报错一起
提到 [Issues](https://github.com/xesws/socrates-pen/issues)。
---
## 6 · 开发 · 测试 · 许可
```bash
npm install
npm test # 十三道闸,见「测试闸门」那张表
npm run build # tsc --noEmit && npm test && esbuild
```
对着一个真库热更新:
```bash
export VAULT_PLUGIN_DIR=/path/to/vault/.obsidian/plugins/socrates-pen
npm run dev
```
没设 `VAULT_PLUGIN_DIR` 时 `npm run dev` 会**直接退出**——防止你把一份陈旧的
副本装进库里。
后端:
```bash
python -m pytest pen/tests -q # 1224 passed
python -m pen.index --check 你的笔记.md
```
想自己复现 [3 章](#3--核心功能逐个上例子)里的所有例子:教材在
[`docs/demo/从零手写DQN.md`](docs/demo/从零手写DQN.md),
每一步的原始请求体和 SSE 事件流在
[`docs/demo/transcripts/`](docs/demo/transcripts/)。
**许可:MIT**,见 [LICENSE](LICENSE)。
---
## 7 · Future Works
现在还做不到、或做得不好的几件事:
**超长划选第一包不再带全文。** 邻域 4000 字、目录 4500 字本来就有上限;划选超过
4000 字时,第一包只留开头和行号,其余按需 `read_file`。长会话可以把旧回合折进
带行号的滚动摘要(命令面板「把这场对话折进摘要」,或到了设置里那道窗口阈值
自动折)——侧栏旧气泡还在,下次请求不再带全文。
**深挖更适合按固定体例写的教材。** 后台追问会去「第三拍 · 出身」「第七拍 · 实操」这类小节
下锚。普通随笔、或没有这些小节的英文教材,主对话不受影响,跨章节的深挖会变弱。可以对照
[`docs/demo/从零手写DQN.md`](docs/demo/从零手写DQN.md)。
**实测过的模型组合还很少。** 这份文档里的例子都跑在 `deepseek/deepseek-v4-flash` 上。别的
OpenAI 兼容节点按协议能接,但没有逐家测过。
---
## 8 · 最近的版本
开发中新增 [固定 MQ Schema](docs/mq-schema-v1.md)、[作答图片测评](evals/answer_images_v2/REPORT.md) 和 [80 题强化学习教材测评](evals/rl_textbook_v1/REPORT.md)。本轮 80 题完整导入;rubric 单题重试后全部通过复核;96 次评分有 1 次多给 10 分。
**开发中,尚未发布 · 练习系统(实验功能,默认关闭)。** 从已有 Meta Questions 导入单选、填空、简答,并补充知识点与评分标准,按 rubric 评分并保留作答日志。独立本地 Analysis 和 Scheduling 服务提供正式作答分析、个性化模型训练与主动领取的推荐队列。[使用与验证](docs/v0.29.0-练习系统.md)
每个小版本都有一份设计说明在 [`docs/`](docs/):读者看到了什么、病根在哪、改了什么、哪道闸守着。
这里只列 0.19 以来的大版本,补丁版顺带一句。
**0.28.0 · 2026-09-21 · Big Bang(实验功能)。** 右上角「+ Agent」在同一窗口打开最多四场独立对话,按面板实际宽高自动分屏;空间不足时纵向滚动。读取和审批绑定文件版本,提交时短锁串行化,过期提案必须重读并重新审批。每个 Agent 可独立停止。[设计与验证](docs/v0.28.0-Big-Bang.md)
**0.27.0 · 2026-09-05 · 不知道链接先搜。** 新工具 `search`,不用任何钥匙、不接 Firecrawl / Tavily 之类的搜索 API:sidecar 自己 GET DuckDuckGo 的纯 HTML 结果页,倒了换 Bing,Wikipedia 总是补一份;三家结果去广告、去内网、按规范化 URL 合并,Reciprocal Rank Fusion 加关键词覆盖排好,一次默认 5 条、最多 10 条,尾注写共几条、还剩几条、下一段的 offset,同一个 query 十分钟内翻页从缓存切。`fetch` 改成按段落编号、带 offset / limit,切片和尾注与 `read_file` 共用同一个定义点,续读同一页不重新下载。[设计说明](docs/v0.27.0-不知道链接先搜.md)
**0.26.0 · 2026-09-03 · 窗口撞了退一批。** 给小窗口模型(64k / 128k)的两道工具层保险。节点回「上下文太长」不再当普通拒绝报给读者:认出六家节点的溢出报文,把这一枪多少 token、模型上限多少连同「改成分段读」一起退回给模型,同一枪重打;退不了的换基座或折一次历史,一轮最多退三次。`read_file` 的截断改成按整行切并写明下一段的 offset,读到一半会说文件共几行,offset / limit 写错是工具错误不再炸掉整轮。[设计说明](docs/v0.26.0-窗口撞了退一批.md)
**0.25.0 · 2026-09-03 · 学习画像。** 侧栏第六枚按钮打开一个独立页签:一张随轴数增长的雷达、
十分制规则分与 BKT 掌握概率并列、每一分怎么来的逐条列出、这个库里每本书的书架。逐轮编码一律主模型,
第一次全量要读者点一下,之后打开面板增量补编,旧日志只进频率不进分。发版前用 Codex(gpt-5.6-sol)
审了一遍整段 diff,修了 16 条。0.25.1:只点芯片没打字的轮次是操作不是证据,不再硬归轴重试三次;
编码器每一枪的原始回复落日志。[设计说明](docs/v0.25.0-学习画像.md)
**0.24.0 · 2026-09-03 · 日志要够看。** 画像的原料。轨迹补上本地时间、读者原话与导师回复全文、
真锚点(阅读视图下对不上行号不再假装在封面)、抛出的追问点没点、写回批准之后那半截、这一轮走的
快模型还是主模型。[设计说明](docs/v0.24.0-日志要够看.md)
**0.23.0 · 2026-09-02 · 厂商方言表与真形状体检。** 推理档 off / low / medium / high 按型号名自动
映射成各家的写法:DeepSeek、Google Gemini、OpenAI、GLM、Kimi、Meta,设置页多一个厂商选择兜底。
配置体检按主对话那一枪的真实形状打,不再猜。0.23.1:Gemini 3 的思考签名要带回去。
[设计说明](docs/v0.23.0-厂商方言表与真形状体检.md)
**0.22.0 · 2026-09-02 · Fast Mode。** 顶栏一枚闪电开关:只读轮次走快模型,写回类轮次仍走基座。
快模型窗口小,压缩策略层按 stub → slim → fold 三档压,压完不污染会话,关掉开关就拿回完整上下文。
0.22.1–0.22.5:降级不再无声、配置体检、体检不许猜、思考正文带回去、Gemini 的推理档。
[设计说明](docs/v0.22.0-Fast%20Mode%20与压缩策略层.md)
**0.21.0 · 2026-09-01 · 自定义泡泡。** 底座那排芯片开放出来:每枚就是读者自己写的一段 prompt,
外加一个「会改写原文」开关;存在 vault 的 data.json 里随库同步,后端全程无状态。预置三个起手模板。
[设计说明](docs/v0.21.0-自定义泡泡.md)
**0.20.0 · 2026-08-30 · 对话框可贴图。** 设置里加「图像理解」开关,开了就能往对话框粘贴或拖入图片
(最多 4 张、每张 2MB),走 OpenAI 兼容的 image_url。落盘时丢掉像素,会话文件不会被撑爆。
[设计说明](docs/v0.20.0-对话框贴图.md)
**0.19.0 · 2026-08-25 · 主对话滚动摘要。** 旧回合折成带行号锚点的抽取式摘要,不加第二次 LLM 调用;
划选超过 4000 字第一包只留开头。命令面板手动折,或到了 `compact_chat_tokens` 阈值自动折。
[设计说明](docs/v0.19.0-主对话compact.md)
---